Machine learning: significado, linguagem Python e IA
Neste artigo
O Google separa spam de conteúdo legítimo, entende que “tênis para corrida” e “calçado para correr” são a mesma busca, enquanto o ChatGPT escreve um parágrafo inteiro sobre um assunto. Por trás das três coisas está a mesma ideia: em vez de alguém escrever todas as regras, a máquina entende padrões a partir de exemplos. Isso é machine learning. E entender esse conceito faz de você um profissional diferenciado em SEO técnico, GEO e automação.
Onde o aprendizado acontece: dos dados à previsão
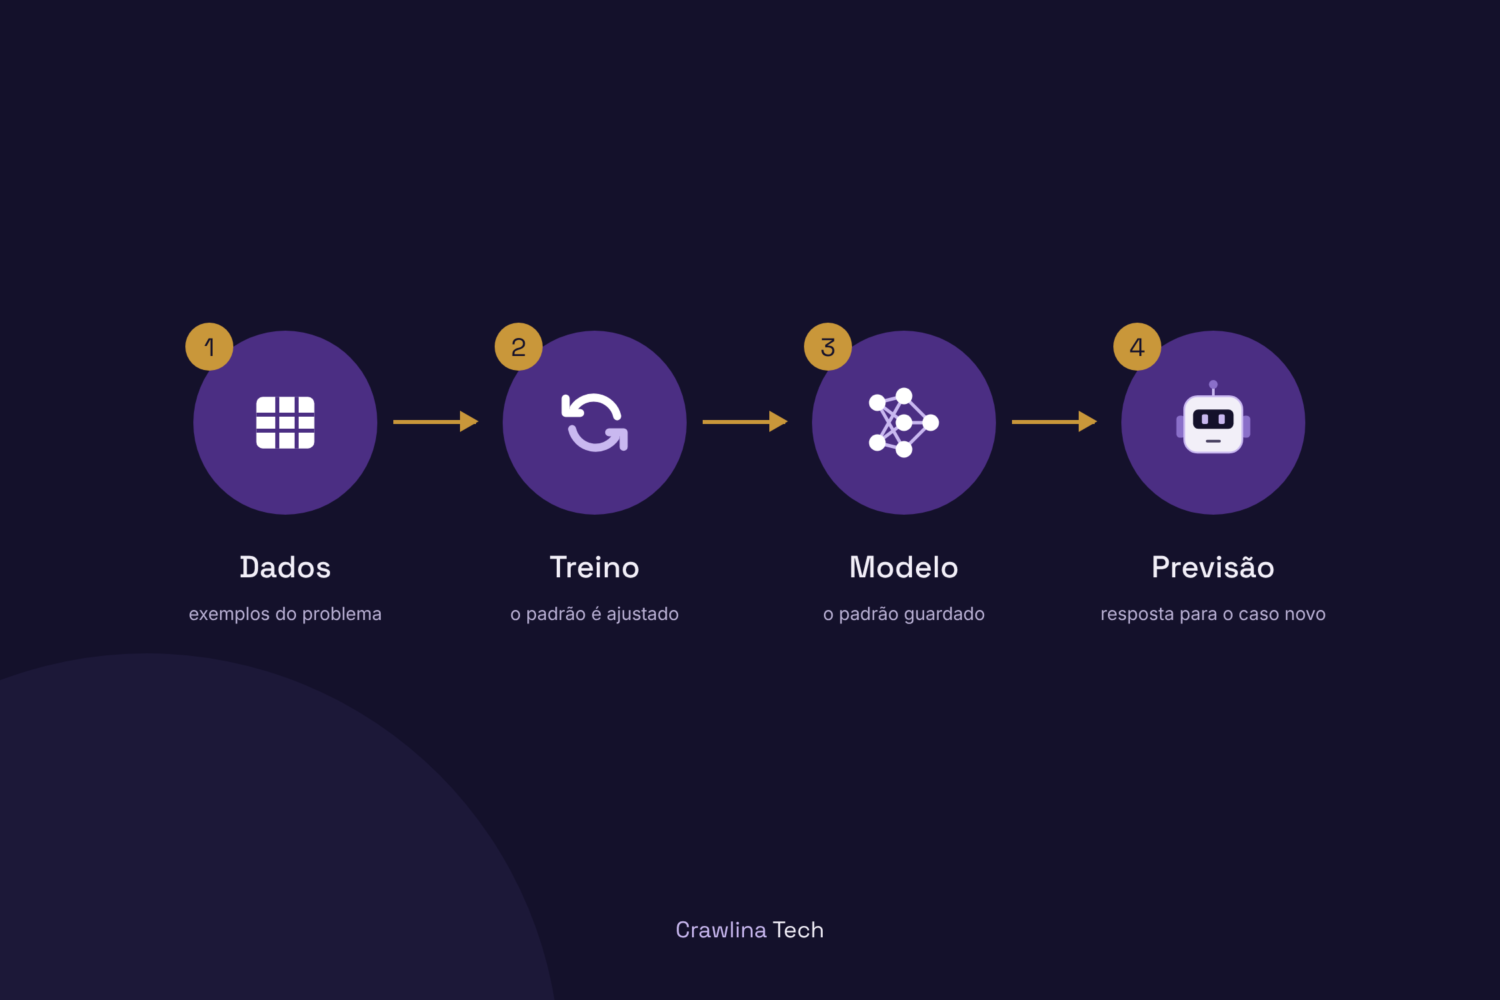
Todo sistema de machine learning passa pelas quatro etapas a seguir:
- Dados: exemplos do problema que você quer resolver – buscas já classificadas, páginas marcadas como spam ou não, textos escritos por pessoas.
- Treino: o algoritmo analisa os exemplos e ajusta os próprios parâmetros até errar o mínimo possível.
- Modelo: o resultado do treino – um conjunto de números que guarda o padrão aprendido.
- Previsão: o modelo recebe um caso que nunca viu e dá uma resposta com base no padrão.
A diferença para a programação tradicional está na segunda etapa. Em um programa comum, uma pessoa escreve a regra: “se a busca tiver a palavra preço, é comercial”. Em machine learning, a pessoa entrega os exemplos e o algoritmo descobre a regra sozinho, inclusive aquelas que ninguém tinha pensado em escrever.
Minha definição
Machine learning é a parte da inteligência artificial em que o computador aprende um padrão a partir de exemplos, em vez de receber esse padrão escrito em regras. Quanto melhores os exemplos, melhor o padrão. Quanto mais o caso novo foge dos exemplos, menos confiável a resposta.
O que é machine learning, segundo quem criou o termo
O termo foi cunhado por Arthur Samuel, pesquisador da IBM, em 1959. No artigo “Some Studies in Machine Learning Using the Game of Checkers“, publicado no IBM Journal of Research and Development, ele descreveu um programa de damas que melhorava jogando contra si mesmo.
A definição mais usada até hoje é de Tom Mitchell, autor do livro Machine Learning, de 1997. Na página do livro, ele resume: machine learning é “o estudo de algoritmos de computador que melhoram automaticamente com a experiência”.
Existem três formas principais de aprender:
- Supervisionado: cada exemplo vem com a resposta certa – o modelo aprende a ligar a entrada à resposta, como classificar buscas por intenção.
- Não supervisionado: os exemplos vêm sem resposta e o modelo encontra grupos sozinho, como agrupar palavras-chave por assunto.
- Por reforço: o modelo testa ações e recebe recompensa ou penalidade, como o programa de damas de Samuel, e também de uma etapa do treino das LLMs.
Machine learning e inteligência artificial não são a mesma coisa
Os termos costumam aparecer como sinônimos, mas um está dentro do outro.
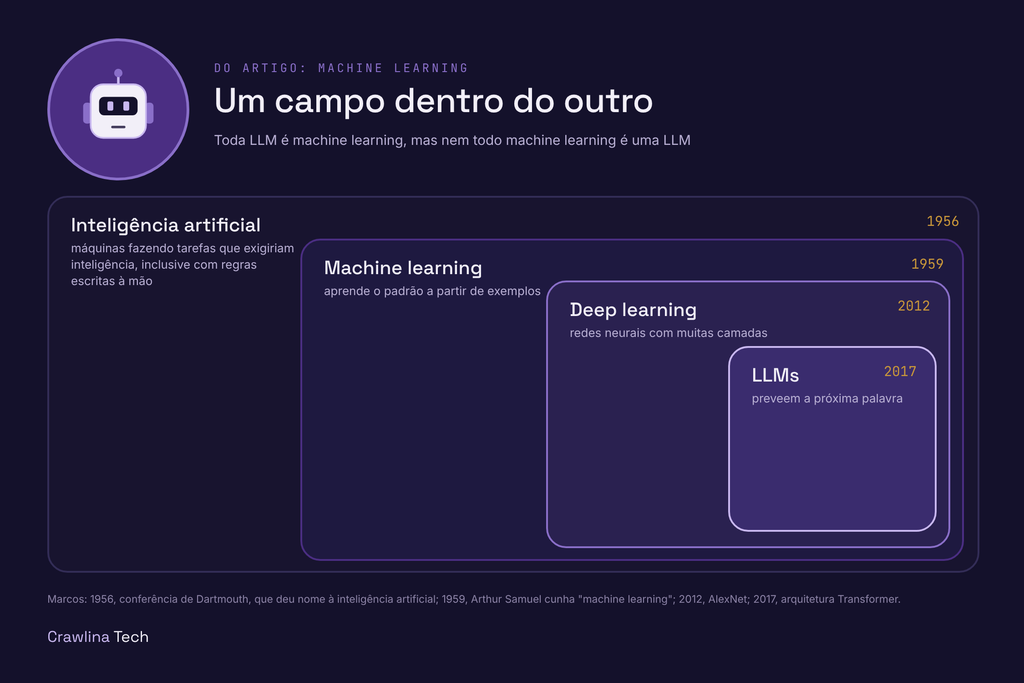
- Inteligência artificial: o campo inteiro, que busca fazer máquinas executarem tarefas que exigem inteligência humana. Inclui sistemas de regras escritas à mão, que não aprendem nada.
- Machine learning: a parte da IA que aprende com dados.
- Deep learning: a parte do machine learning que usa redes neurais com muitas camadas e ganhou força a partir de 2012, quando a rede AlexNet venceu com folga uma competição de reconhecimento de imagens.
- LLMs: modelos de deep learning treinados em volumes enormes de texto, construídos sobre a arquitetura Transformer, apresentada em 2017 no artigo “Attention Is All You Need”.
Toda LLM é machine learning, mas nem todo machine learning é uma LLM. Um modelo que prevê cancelamento de clientes a partir de uma planilha também é machine learning, mas não tem nada de linguagem.
Machine learning em Python
Python virou a língua padrão do machine learning. No Octoverse 2025, relatório anual do GitHub, o TypeScript passou o Python como linguagem mais usada na plataforma. Mas o mesmo relatório mostra que Python “agora move quase metade de todos os novos repositórios de IA”: 582.196 repositórios, alta de 50,7% em um ano.
O motivo está nas bibliotecas. As três mais usadas:
- scikit-learn: machine learning clássico, como classificação, regressão e agrupamento – o melhor ponto de partida.
- PyTorch: deep learning – a base de boa parte das pesquisas e dos modelos de linguagem atuais.
- TensorFlow e Keras: deep learning, com o Keras como camada mais simples por cima.
Um exemplo pequeno, com o scikit-learn, que classifica buscas por intenção. Dez exemplos já classificados viram a experiência do modelo, e ele prevê a intenção de buscas que nunca viu:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline

# Exemplos que você já classificou: a experiência do modelo
buscas = [
    "o que é canonical", "como funciona o rag", "o que significa indexação",
    "como fazer auditoria de seo", "para que serve o robots.txt",
    "contratar consultoria de seo", "preço de auditoria seo",
    "agência de seo técnico em são paulo", "orçamento consultoria geo",
    "consultoria seo para ecommerce",
]
intencao = ["informacional"] * 5 + ["comercial"] * 5

# Treino: o modelo aprende quais palavras pesam para cada intenção
modelo = make_pipeline(TfidfVectorizer(), LogisticRegression())
modelo.fit(buscas, intencao)

# Previsão para buscas que o modelo nunca viu
novas = ["o que é dado estruturado", "valor de consultoria de seo"]
print(modelo.predict(novas))
# ['informacional' 'comercial']
O código transforma cada busca em números, que o TfidfVectorizer calcula a partir das palavras, e o modelo aprende quais palavras pesam para cada intenção. Ninguém escreveu a regra. Foi o modelo encontrou padrões nos exemplos. Com dez exemplos, ele entende o mecanismo, mas ainda não está preparado para um projeto real. Isso fica mais claro na seção sobre limites.
O paralelo com as LLMs
Uma LLM faz, em escala gigante, o mesmo que o exemplo acima. Em vez de dez buscas, ela aprende com bilhões de textos. Em vez de prever uma intenção, ela prevê a próxima palavra, como explicamos em como a IA escolhe quais conteúdos mostrar.
As três formas de aprender aparecem no treino de uma LLM:
- Pré-treino: o modelo aprende a prever a próxima palavra em textos que já existem – o próprio texto fornece a resposta certa, então não é preciso classificar nada à mão.
- Ajuste com exemplos: pessoas escrevem perguntas e respostas ideais, e o modelo aprende a seguir instruções – isso é aprendizado supervisionado.
- Ajuste por preferência: pessoas comparam respostas e indicam a melhor – o modelo é recompensado por gerar respostas parecidas. É aprendizado por reforço, que você aprendeu em por que a IA opina, e o que está por trás disso.
A consequência prática é a mesma do exemplo em Python: o modelo é tão bom quanto os padrões que encontrou nos dados. Ele não sabe o que é verdade, sabe o que é provável.
Machine learning no SEO técnico
O Google usa machine learning há anos e diz isso na própria documentação. O guia de sistemas de ranqueamento lista quatro sistemas ligados a linguagem:
- RankBrain: “ajuda a entender como as palavras se relacionam com conceitos”.
- Neural matching: serve “para entender representações de conceitos em buscas e páginas e combiná-las”.
- BERT: “permite entender como combinações de palavras expressam significados e intenções diferentes”.
- MUM: “um sistema de IA capaz de entender e gerar linguagem”.
No combate ao spam, o caso mais claro é o SpamBrain, sistema de prevenção de spam baseado em IA lançado em 2018. Segundo o relatório de spam do Google de 2022, noticiado pelo Search Engine Land, o SpamBrain identificou cinco vezes mais sites de spam do que em 2021 e 200 vezes mais do que no lançamento. A atualização de links de spam de dezembro de 2022 foi uma atualização do próprio SpamBrain, o que multiplicou por 50 a detecção de sites de link spam.
Isso muda a forma de pensar SEO técnico. Um modelo treinado não segue uma lista fixa de regras que dá para contornar uma por uma. Ele reconhece padrões. Uma rede de links artificiais pode não violar nenhuma regra escrita e, mesmo assim, ter o mesmo padrão de milhares de redes que o modelo já viu.
Machine learning e GEO
Na busca com IA, o machine learning aparece em cada uma das etapas. O sistema transforma a pergunta e os trechos de conteúdo em vetores com um modelo de embeddings, busca os trechos mais próximos e passa o resultado por um modelo de reordenação, como explicado em como a IA escolhe fontes para citar, entre tantas. Só depois a LLM escreve a resposta.
São pelo menos três modelos treinados decidindo se o seu conteúdo entra na resposta. Nenhum deles lê o texto como uma pessoa. Todos procuram padrões que aprenderam no treino: correspondência de significado com a pergunta, especificidade, trechos que fazem sentido sozinhos. É por isso que o GEO, como descrito em como transformar cinco mecanismos em uma estratégia, trabalha com estrutura e evidência, não com truques de palavra-chave.
Onde entra o n8n
O n8n não treina modelos. Ele coloca modelos já treinados para trabalhar dentro de um processo. A página de integrações tem nós de embeddings para OpenAI, Google Gemini e Anthropic, além de categorias inteiras para embeddings, bancos vetoriais e reordenação, as mesmas peças da busca com IA.
Na prática, o classificador de intenção do exemplo em Python poderia virar uma etapa de um workflow: a palavra-chave entra em uma planilha, o modelo classifica e o n8n envia cada grupo para o tipo de conteúdo certo. Como montar esse tipo de fluxo está em n8n, templates e automação.
Se fosse só treinar um modelo, todo mundo teria um
Calma, porque é aqui que muitos projetos de machine learning falham. O código do exemplo tem dez linhas. O trabalho de verdade está em outro lugar.
1. Dado ruim gera modelo ruim: se os exemplos estiverem classificados errado, ou só cobrirem um tipo de busca, o modelo aprende o erro com a mesma eficiência com que aprenderia o acerto.
2. Decorar não é aprender: com poucos exemplos, o modelo pode acertar tudo no treino e errar no mundo real, porque decorou os exemplos em vez de aprender o padrão, o que chamamos de overfitting. A forma de perceber é testar sempre com dados que ficaram fora do treino.
3. O mundo muda e o modelo não: um modelo treinado com buscas de 2024 não conhece termos que surgiram depois. Todo modelo em uso precisa ser medido e, de tempos em tempos, treinado de novo.
Livros para estudar machine learning
Em ordem, do fundamento à prática:
- Inteligência Artificial: Uma Abordagem Moderna: Stuart Russell e Peter Norvig, 4ª edição, LTC, 2022. O livro-texto mais usado em cursos de IA, que mostra onde o machine learning se encaixa no campo inteiro.
- Machine Learning: Tom Mitchell, McGraw Hill, 1997. A obra que deu a definição clássica do termo. É antiga, mas os fundamentos não mudaram.
- Mãos à Obra: Aprendizado de Máquina com Scikit-Learn, Keras & TensorFlow: Aurélien Géron, 2ª edição, Alta Books, 2021, tradução de Cibelle Ravaglia. O mais prático da lista, todo em Python.
- Deep Learning: Ian Goodfellow, Yoshua Bengio e Aaron Courville, MIT Press, 2016. Referência em redes neurais, com a versão completa gratuita no site oficial.
- Build a Large Language Model (From Scratch): Sebastian Raschka, Manning, 2024. Constrói um modelo no estilo GPT do zero, em Python. É a ponte direta entre machine learning e LLMs.
O que ninguém sabe ainda
- Peso de cada sistema no ranking: o Google lista os sistemas, mas não publica quanto cada um pesa nem como eles se combinam.
- O que os modelos realmente aprendem: nas redes neurais grandes, é difícil explicar por que uma decisão foi tomada. A área que estuda isso, chamada interpretabilidade, ainda está no começo.
- Como medir GEO com precisão: os modelos de recuperação e reordenação das ferramentas de IA não são públicos, então toda medição é feita de fora, observando as respostas.
Checklist para começar
- Comece pelo problema: defina o que quer prever antes de escolher a ferramenta.
- Junte exemplos: centenas de casos bem classificados valem mais do que milhares de casos duvidosos.
- Separe uma parte para teste: nunca avalie o modelo com os mesmos dados do treino.
- Comece pelo scikit-learn: modelos simples resolvem boa parte dos problemas de SEO, como classificar buscas ou agrupar páginas.
- Use modelos prontos quando fizer sentido: para tarefas de linguagem, chamar uma LLM pelo n8n pode ser mais rápido do que treinar um modelo próprio.
- Meça depois de colocar em uso: acompanhe os erros e treine de novo quando o desempenho cair.
Perguntas frequentes sobre machine learning
Perguntas frequentes sobre machine learning
Qual a diferença entre machine learning e inteligência artificial?
Inteligência artificial é o campo inteiro, que inclui sistemas com regras escritas à mão. Machine learning é a parte da IA em que o computador aprende os padrões a partir de exemplos. Deep learning e LLMs estão dentro do machine learning.
Preciso saber Python para trabalhar com machine learning?
Para treinar os próprios modelos, Python é o caminho mais comum, por causa de bibliotecas como scikit-learn e PyTorch. Para usar modelos prontos, como as LLMs, dá para trabalhar sem programar, com ferramentas como o n8n.
ChatGPT é machine learning?
Sim. O ChatGPT é uma LLM, um modelo de deep learning treinado com machine learning em três etapas: previsão da próxima palavra, ajuste com exemplos escritos por pessoas e ajuste por preferência humana.
O Google usa machine learning para ranquear sites?
Sim, e diz isso na própria documentação. RankBrain, neural matching, BERT e MUM são sistemas de linguagem usados no ranqueamento, e o SpamBrain usa IA para detectar spam. O Google não publica quanto cada sistema pesa no resultado.
Qual livro ler primeiro?
Para entender o campo, Inteligência Artificial: Uma Abordagem Moderna, de Russell e Norvig. Para colocar a mão no código, Mãos à Obra, de Aurélien Géron, que tem edição em português e usa Python do começo ao fim.
Onde isso se conecta
Machine learning é a base de tudo o que esta série investiga. A previsão da próxima palavra está em LLMs, como a IA escolhe quais conteúdos mostrar. A busca por significado está em RAG, o mecanismo por trás da citação em resposta de IA. E a forma de colocar modelos para trabalhar num processo está em n8n, templates e automação.
Fontes
- Machine Learning, Tom Mitchell, Carnegie Mellon University
- Attention Is All You Need, Vaswani et al., arXiv
- Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1, GitHub
- A guide to Google Search ranking systems, Google Search Central
- Google webspam report: SpamBrain caught 5x more spam, Search Engine Land
- Google SpamBrain: AI-based spam prevention system launched in 2018, Search Engine Land
- Integrations, n8n
- Deep Learning, Goodfellow, Bengio e Courville
Gabriely Rodrigues
Fundadora da Crawlina Tech, especialista em SEO técnico, embaixadora e professora na EducaSEO. Investiga como a busca com IA encontra, entende e cita conteúdo.