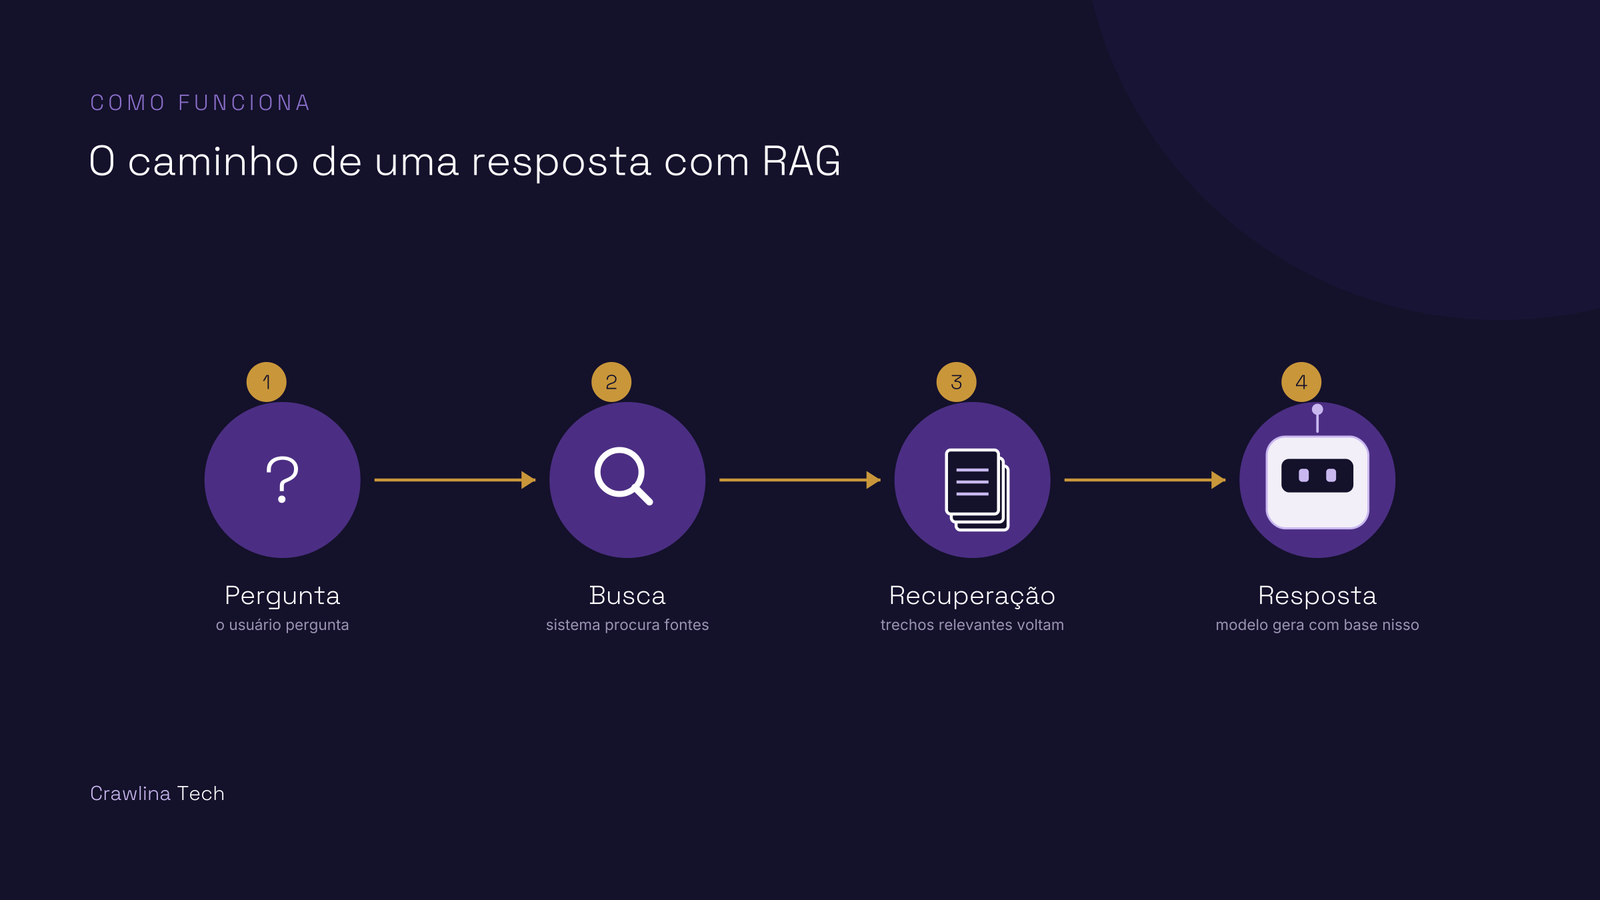
No artigo anterior você entendeu como um modelo de linguagem busca e recupera informação antes de responder, o RAG. Mas recuperar a informação certa não adianta nada se o modelo não souber o que fazer com ela. É aqui que entra a peça que realmente escreve a resposta: o LLM.
Antes de mais nada, o que é um LLM?
LLM é a sigla para Large Language Model, ou modelo de linguagem de grande escala, em português. É o tipo de sistema por trás do ChatGPT, do Gemini, do Claude, e de praticamente todo assistente de IA que gera texto respondendo você.
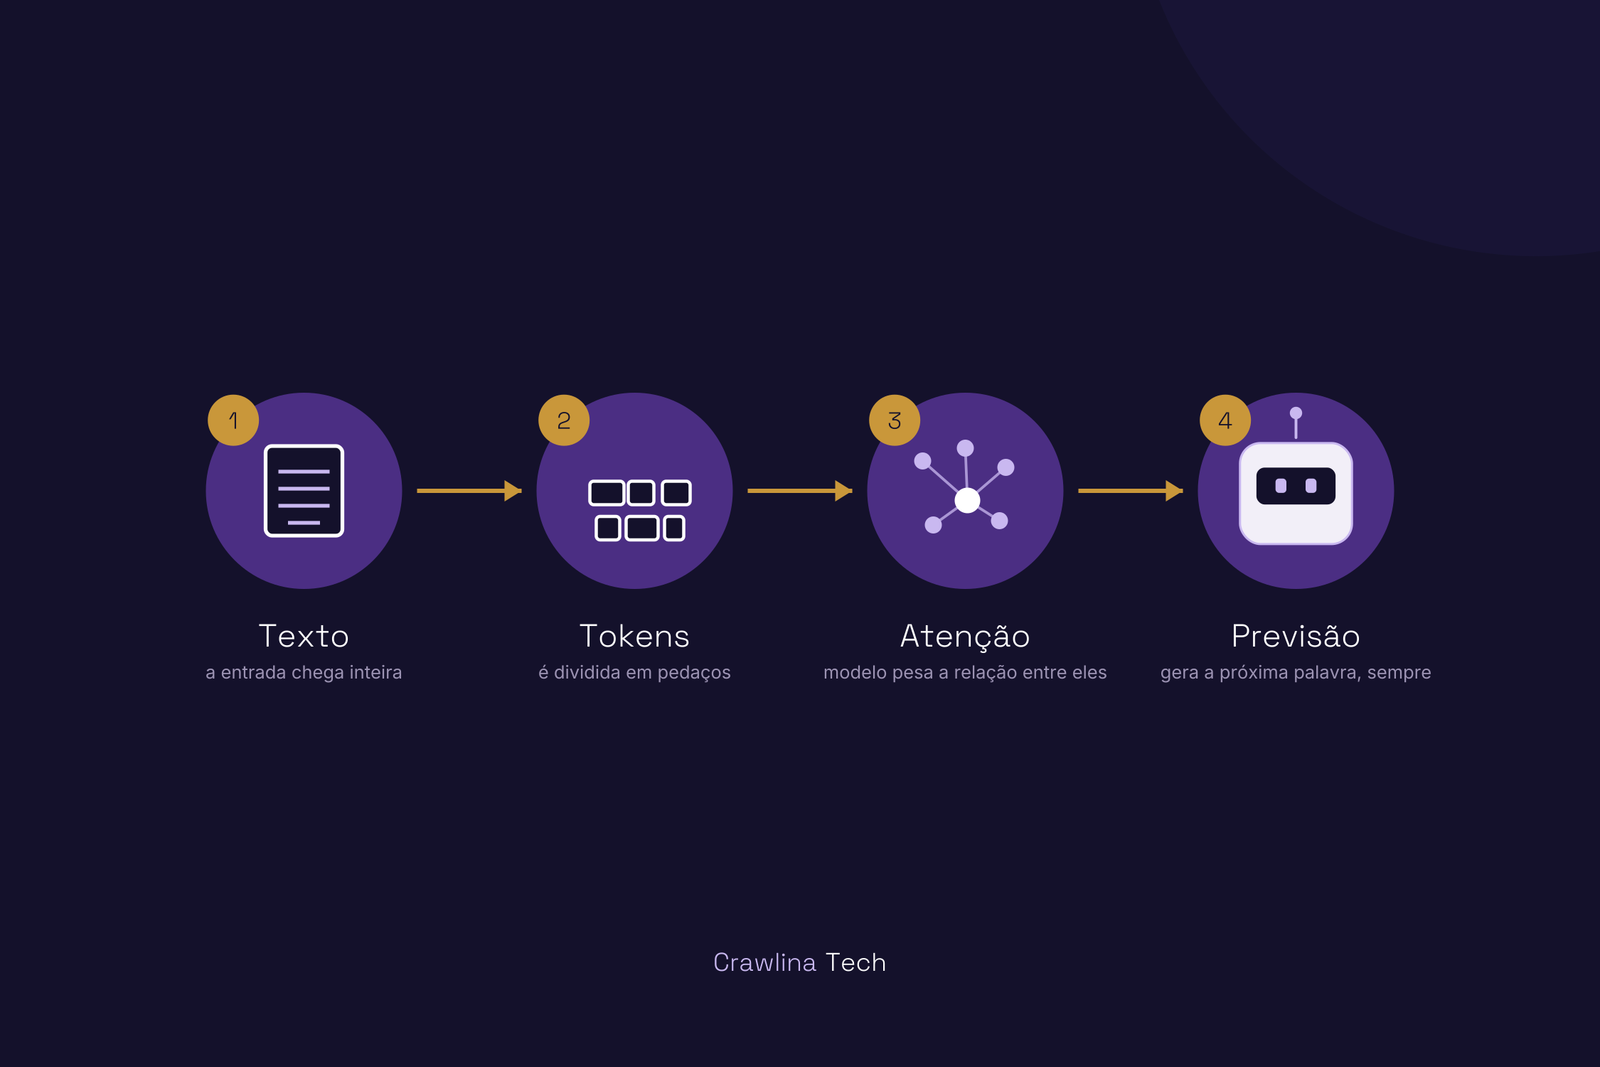
Mas calma antes de pensar em algo muito abstrato. Na essência, um LLM faz uma coisa só, e a faz repetidamente: prevê qual é a próxima palavra mais provável, dado tudo o que veio antes dela. Só isso. A conversa fluida, a resposta que parece raciocinar, o texto que soa natural, tudo isso é resultado de fazer essa previsão, palavra por palavra, bilhões de vezes, com muita precisão estatística.
Parece simples demais pra explicar algo tão poderoso, eu sei. E é exatamente aí que mora o mal-entendido mais comum sobre o assunto.
De onde veio esse conceito
A arquitetura que tornou os LLMs atuais possíveis nasceu em 2017, num artigo de pesquisadores do Google chamado “Attention Is All You Need”. Ele apresentou o Transformer, um jeito novo de processar linguagem que, em vez de ler uma palavra de cada vez em sequência, como os modelos anteriores faziam, consegue olhar para todas as palavras de um texto ao mesmo tempo e decidir quais delas importam mais pra entender cada parte.
Esse mecanismo de “decidir o que importa mais” se chama atenção, e é literalmente de onde vem o nome do artigo. Ele é o motivo pelo qual um modelo consegue entender que, na frase “o cliente que reclamou ontem voltou a comprar”, o “voltou” se refere ao cliente, não à reclamação, mesmo com várias palavras no meio. Sem isso, não existiria ChatGPT, Gemini, Claude, nem nenhum modelo de linguagem como os que usamos hoje.
O que isso muda no entendimento de “pensar”
Aqui vale um esclarecimento direto, porque ele muda a forma como você deveria escrever pra esse tipo de sistema: um LLM não verifica fato, ele estima probabilidade. Se um erro comum aparece descrito com muita frequência e consistência nos dados que o modelo processou, ele pode “prever” aquele erro como se fosse a resposta certa, com a mesma confiança que usaria pra uma informação verdadeira.
É exatamente esse problema que o RAG, do artigo anterior, existe pra reduzir: em vez de o modelo confiar só na previsão baseada em padrão, ele consulta uma fonte real antes de responder. RAG e LLM não competem entre si, um recupera informação, o outro decide como usar essa informação pra formar frase. São duas camadas do mesmo processo, e cada uma tem uma função diferente.
Token, não palavra
Um detalhe técnico que muda como você deveria pensar sobre otimização de texto: o modelo não processa “palavra por palavra” no sentido literal, ele processa em tokens, que são pedaços de palavra. “Reconhecimento” pode virar dois ou três tokens diferentes, dependendo de como o texto foi cortado pelo tokenizador daquele modelo específico.
Isso explica por que termo técnico muito específico, sigla pouco usada, ou nome próprio raro, às vezes confunde o modelo mais do que deveria: ele nunca viu aquela combinação exata de tokens com frequência suficiente pra prever bem o que vem depois dela. Termo comum e bem estabelecido tende a ser processado com mais precisão do que neologismo ou jargão interno de nicho.
Por que isso muda o jeito de escrever pra ser entendido
1. Ambiguidade custa caro. Se uma frase pode ser lida de duas formas diferentes, o modelo vai escolher a interpretação estatisticamente mais provável, não necessariamente a que você quis dizer. Clareza sintática não é luxo de redator obsessivo, é o que garante que a ideia certa seja a mais previsível dali.
2. Contexto explícito supera contexto implícito. Um humano entende referência indireta, ironia, e informação subentendida pelo tom. Um modelo entende melhor quando a relação entre as ideias está dita, não sugerida. “O CAC caiu porque o orgânico passou a suprir parte da demanda” recupera e processa melhor do que deixar essa conexão implícita.
3. Termo consistente ao longo do texto. Trocar de sinônimo por variedade estilística, prática comum em texto pensado só pra leitor humano, pode fragmentar como o modelo conecta os tokens relacionados ao mesmo conceito. Isso não significa escrever repetitivo, significa ser consistente com o termo central de cada seção.
Se fosse só prever a próxima palavra, a resposta seria decorada
Calma, porque tem uma pergunta óbvia aqui: se o modelo só prevê a próxima palavra mais provável, como ele consegue responder pergunta que nunca viu exatamente daquele jeito antes?
A resposta está na escala. O modelo não decorou frase, ele aprendeu padrão de linguagem, relação entre conceito, e estrutura de raciocínio, a partir de uma quantidade de texto que nenhum ser humano conseguiria ler numa vida inteira. Isso permite generalizar pra situação nova, combinando padrões conhecidos de um jeito que nunca apareceu exatamente igual antes. Não é criatividade no sentido humano da palavra, mas também não é decoreba simples. É outra coisa, no meio do caminho, e é por isso que o resultado engana tanto.
E o erro mais comum de quem tenta escrever pra IA é tratar isso como uma fórmula fixa, tipo “sempre comece com definição, sempre feche com lista”. Não existe fórmula única, porque o modelo está avaliando probabilidade em cada contexto específico, não seguindo um roteiro decorado. O que existe são princípios, os que você acabou de ler, não receita pronta.
O que vem depois de entender LLM
Se você ainda não leu, vale voltar em RAG pra entender a camada de busca que alimenta o modelo antes dele processar qualquer coisa. As duas juntas, recuperação e geração, são a base técnica de tudo.
Agora, com as duas camadas entendidas, dá pra falar de estratégia de verdade: o que fazer, na prática, pra aumentar a chance de ser citado. Isso é assunto de GEO e Busca com IA, o próximo artigo dessa série.
Se você trabalha com um site que depende de tráfego orgânico pra gerar receita, entender essas duas camadas não é curiosidade técnica, é a base de qualquer decisão de conteúdo daqui pra frente. Se quiser conversar sobre como isso se aplica ao seu caso específico, me chama.