Deep Learning: o que é e como influencia no SEO e nas LLMs
Neste artigo
O Google entende que uma busca escrita de jeito estranho quer dizer a mesma coisa que uma busca bem escrita. O celular reconhece o seu rosto no escuro. O ChatGPT escreve uma resposta inteira sobre um assunto que nunca viu. As três coisas vêm da mesma técnica: redes neurais com muitas camadas, cada uma aprendendo uma parte do problema. Isso é deep learning, a parte do machine learning que transformou a busca nos últimos anos.
Onde o aprendizado acontece: camada por camada
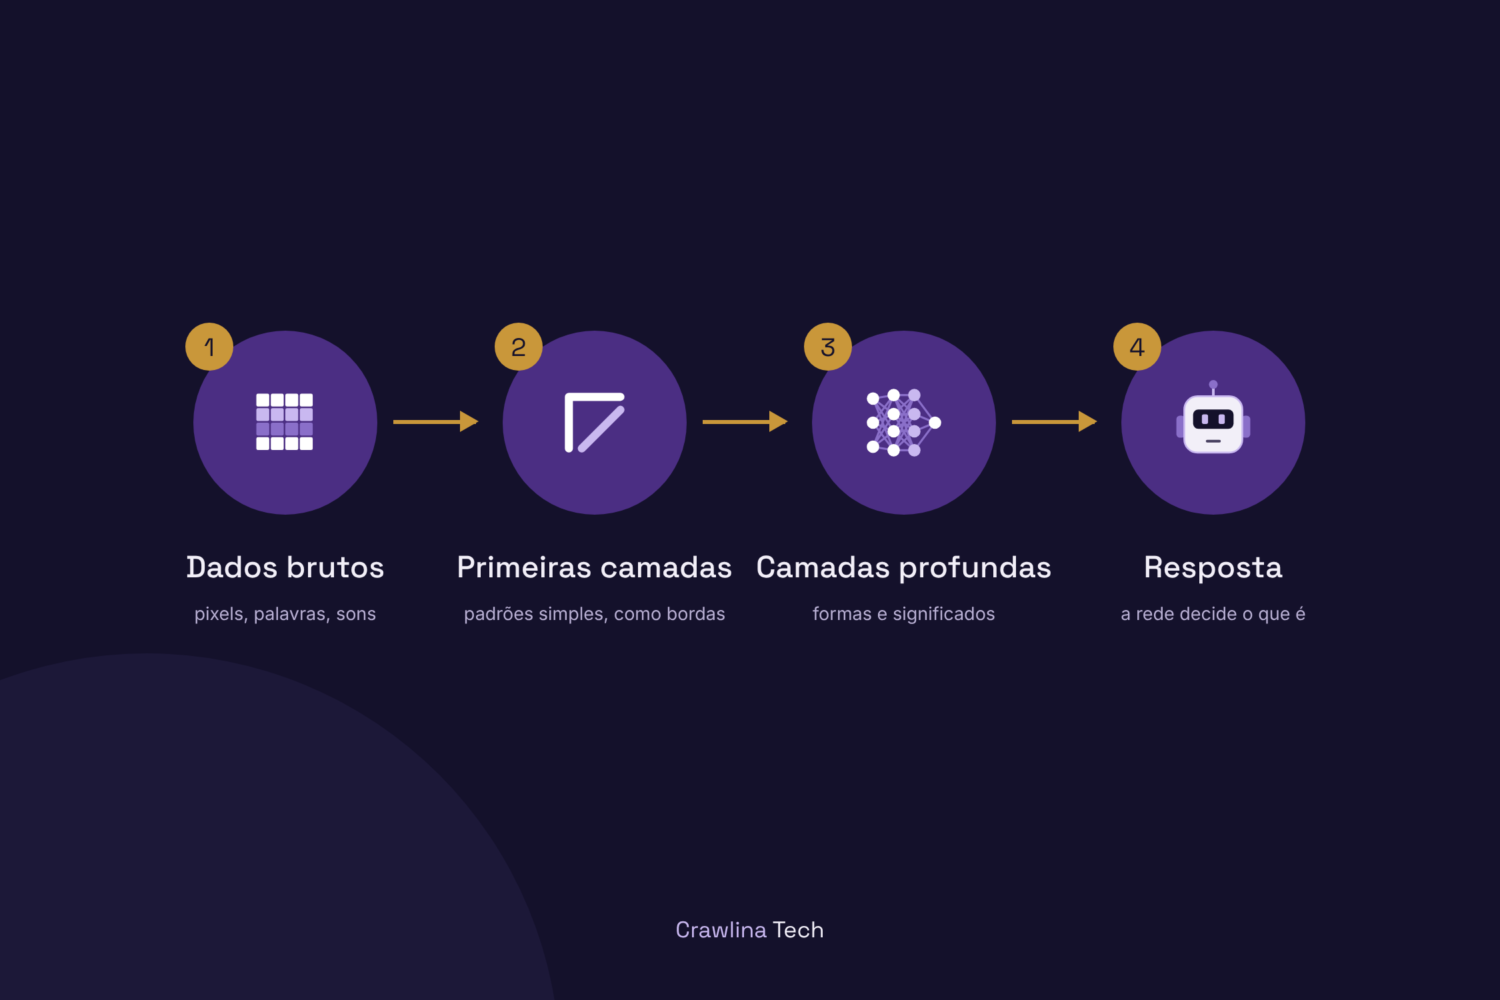
Uma rede de deep learning recebe o dado bruto e passa por várias camadas até chegar a uma resposta. Em uma rede que reconhece imagens, o caminho é este:
- Dados brutos: a rede recebe os pixels da imagem, sem nenhuma explicação sobre o que eles representam
- Primeiras camadas: aprendem padrões simples, como bordas, cantos e contrastes
- Camadas profundas: combinam os padrões simples em formas mais complexas, como um olho, uma roda ou uma letra
- Resposta: a última camada junta tudo e decide o que está na imagem
A palavra “deep”, profundo em inglês, vem daí: muitas camadas empilhadas. E ninguém diz à rede que a primeira camada deve procurar as bordas. Ela descobre sozinha, durante o treino, que procurar bordas ajuda a acertar.
Minha definição
Deep learning é o machine learning feito com redes neurais de muitas camadas, em que cada camada aprende a representar o dado de um jeito um pouco mais abstrato que a anterior. A rede não precisa que alguém diga quais características olhar. Em troca, ela pede muito mais dados e muito mais poder de computação.
O que é deep learning, segundo quem ajudou a criar a área
Em 2015, Yann LeCun, Yoshua Bengio e Geoffrey Hinton publicaram na revista Nature o artigo “Deep learning”, que virou a referência da definição. A primeira frase do resumo diz que o deep learning “permite que modelos computacionais compostos de múltiplas camadas de processamento aprendam representações de dados com múltiplos níveis de abstração”.
Os três receberam em 2019 o Prêmio Turing de 2018, considerado o principal prêmio da computação. A ACM justificou o prêmio “por avanços conceituais e de engenharia que tornaram as redes neurais profundas um componente crítico da computação”.
Em 2024, Hinton dividiu o Nobel de Física com John Hopfield, “por descobertas e invenções fundamentais que permitem o machine learning com redes neurais artificiais”, segundo a Scientific American. As redes neurais existiam havia décadas. O que mudou foi a combinação de três coisas: mais dados, placas de vídeo capazes de fazer o cálculo em paralelo e técnicas melhores para treinar redes com muitas camadas.
2012, o ano em que o deep learning ganhou a disputa
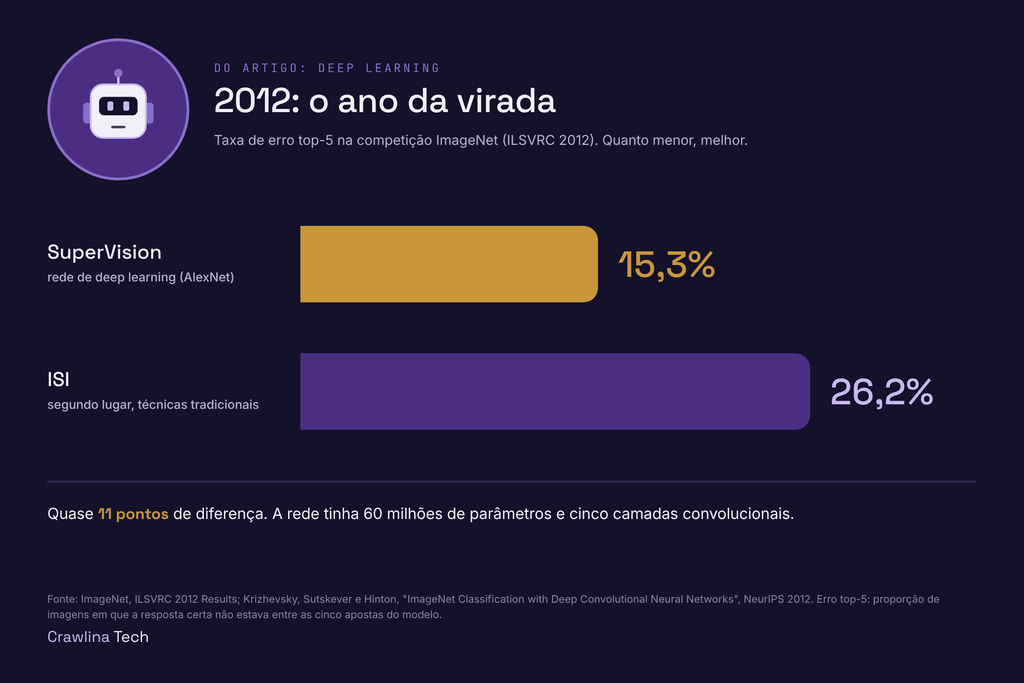
O marco mais citado é a competição de reconhecimento de imagens ImageNet de 2012. Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton inscreveram uma rede neural profunda, depois chamada de AlexNet, com 60 milhões de parâmetros e cinco camadas convolucionais, descrita no artigo “ImageNet Classification with Deep Convolutional Neural Networks”.
Segundo os resultados oficiais, a equipe SuperVision teve taxa de erro top-5 de 15,3%. O segundo colocado, que usava técnicas tradicionais, ficou em 26,2%. Erro top-5 é a proporção de imagens em que a resposta certa não estava entre as cinco apostas do modelo. Uma diferença de quase 11 pontos em uma competição em que os avanços costumavam ser pequenos fez a área inteira mudar de direção.
Machine learning e deep learning: onde termina um e começa o outro
Deep learning está dentro do machine learning, como mostrado em o que é machine learning. A diferença está em quem decide o que o modelo deve olhar.
- Características: no machine learning clássico, uma pessoa escolhe o que entra no modelo, como o número de palavras de uma busca ou a presença do termo “preço”. No deep learning, a rede aprende sozinha quais características importam a partir do dado bruto.
- Tipo de dado: o machine learning clássico vai bem com tabelas e planilhas. O deep learning se destaca em dados sem estrutura, como texto, imagem e áudio.
- Volume de dados: modelos clássicos funcionam com poucos milhares de exemplos. Redes profundas costumam precisar de muito mais para não decorar os exemplos.
- Computação: modelos clássicos treinam em um notebook comum. Redes profundas grandes pedem placas de vídeo e horas, dias ou semanas de treino.
- Explicação: em uma regressão, dá para ver o peso de cada variável. Em uma rede profunda, a decisão está espalhada por milhões de números, e explicar o porquê de uma resposta é bem mais difícil.
Na prática, um não substitui o outro. Para prever cancelamento de clientes a partir de uma planilha, um modelo clássico costuma resolver com menos custo. Para entender o significado de uma busca, reconhecer uma imagem ou gerar texto, o deep learning é o caminho.
Deep learning em Python
Python também é a língua padrão do deep learning. As bibliotecas mais usadas:
- PyTorch: a base de boa parte das pesquisas e dos modelos de linguagem atuais.
- TensorFlow e Keras: o Keras é a camada mais simples e na versão 3 funciona por cima de TensorFlow, PyTorch ou JAX.
- JAX: biblioteca do Google para cálculo numérico em placas de vídeo, usada em pesquisa.
Para ver o mecanismo sem instalar nada pesado, o scikit-learn tem uma rede neural simples, o MLPClassifier. O exemplo abaixo usa um conjunto de dados que vem com a biblioteca: 1.797 imagens de dígitos escritos à mão, de 8 por 8 pixels. A rede tem duas camadas ocultas e aprende a reconhecer qual número está em cada imagem:
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

# 1.797 imagens de dígitos escritos à mão, de 8 x 8 pixels
X, y = load_digits(return_X_y=True)
X_treino, X_teste, y_treino, y_teste = train_test_split(X, y, test_size=0.25, random_state=42)

# Rede neural com duas camadas ocultas: 64 e 32 neurônios
rede = MLPClassifier(hidden_layer_sizes=(64, 32), max_iter=500, random_state=42)
rede.fit(X_treino / 16, y_treino)

print(f"Acerto em imagens que a rede nunca viu: {rede.score(X_teste / 16, y_teste):.1%}")
# Acerto em imagens que a rede nunca viu: 97.3%
A rede recebe só os 64 pixels de cada imagem. Ninguém explicou que o 8 tem duas voltas ou que o 1 é um traço vertical. A primeira camada oculta aprende combinações de pixels, a segunda une essas combinações e a camada de saída escolhe o dígito. A divisão por 16 coloca os pixels, que vão de 0 a 16, na faixa de 0 a 1, o que facilita o treino. Um quarto das imagens ficou fora do treino. É nelas que o acerto de 97,3% foi medido.
Duas camadas ocultas servem para entender a ideia. Os modelos usados em produção têm muito mais camadas e são treinados com PyTorch ou TensorFlow, em placas de vídeo.
O paralelo com as LLMs
Toda LLM é um modelo de deep learning. A arquitetura usada por elas, o Transformer, foi apresentada em 2017 no artigo “Attention Is All You Need”. Ela troca a imagem de dígitos por texto e o reconhecimento de um número pela previsão da próxima palavra, como explicado em como a IA escolhe quais conteúdos mostrar.
O princípio das camadas continua o mesmo! As primeiras camadas lidam com pedaços de palavras e a relação entre eles. As camadas seguintes montam significados cada vez mais amplos, até a rede conseguir prever uma continuação que faz sentido. A diferença para o exemplo em Python está na escala: em vez de duas camadas ocultas e milhares de parâmetros, dezenas de camadas e bilhões de parâmetros, treinados com uma parte enorme do texto público da internet.
Deep learning no SEO técnico
O caso mais conhecido é o BERT. Quando o Google colocou o modelo na busca, em outubro de 2019, Pandu Nayak, vice-presidente de busca, escreveu no blog oficial que o BERT ajudaria a busca a “entender melhor uma em cada 10 buscas nos EUA, em inglês”. O exemplo do próprio texto é a palavra “to” em uma busca sobre viagem do Brasil para os Estados Unidos: antes, o sistema ignorava a preposição e mostrava resultados sobre o caminho contrário.
Hoje o guia de sistemas de ranqueamento do Google lista o BERT ao lado do RankBrain, do neural matching e do MUM. Os quatro são sistemas de linguagem baseados em redes neurais.
Para o SEO técnico, a consequência é direta. Um modelo de deep learning compara significados, não palavras soltas. Repetir a palavra-chave não convence a rede de que a página responde a busca. O que ajuda é deixar claro, em cada parte do conteúdo, qual pergunta ela responde e garantir que o Google consiga rastrear, renderizar e indexar esse conteúdo.
Deep learning e GEO
Na busca com IA, praticamente cada etapa é um modelo de deep learning. O modelo de embeddings transforma a pergunta e os trechos de conteúdo em vetores. O modelo de reordenação decide quais trechos chegam até a resposta. E a LLM escreve o texto final. Como esses três passos escolhem o que citar está em como a IA escolhe fontes para citar e no mecanismo por trás da citação de IA.
Um embedding é, na prática, a saída de uma das camadas profundas de uma rede: o significado de um trecho guardado em uma lista de números. Dois trechos com o mesmo significado ficam próximos, mesmo com palavras diferentes. É por isso que o GEO, como descrito em como transformar cinco mecanismos em uma estratégia, trabalha com trechos que fazem sentido sozinhos, específicos e com evidência.
Onde entra o n8n
Treinar uma rede profunda do zero está fora do alcance da maioria das empresas. Usar uma já treinada, não. A página de integrações do n8n tem nós para OpenAI, Google Gemini e Anthropic, além de categorias para embeddings e bancos vetoriais. Todos esses nós chamam modelos de deep learning.
Um uso prático em SEO: um workflow recebe uma lista de páginas, gera o embedding de cada uma e agrupa as que tratam do mesmo assunto, o que ajuda a encontrar canibalização ou lacunas de conteúdo. Como montar esse tipo de fluxo está em templates e automação de n8n.
Se fosse só empilhar camadas, todo problema já estaria resolvido
Mais camadas não significam um modelo melhor. O deep learning tem limites que aparecem rápido em projeto real.
1. Rede grande com poucos dados decora: quanto mais parâmetros, mais fácil é pra a rede memorizar os exemplos em vez de aprender o padrão. Com poucos dados, um modelo clássico costuma ir melhor.
2. Custo alto: treinar redes grandes exige placas de vídeo, tempo e energia. Para a maioria dos casos, faz mais sentido usar um modelo pronto ou ajustar um modelo existente do que treinar um do zero.
3. A rede não explica a própria resposta: ela acerta ou erra sem dizer por quê. Em decisões que precisam de justificativa, isso é um problema, por isso testar com dados que ficaram fora do treino se torna obrigatório.
4. A rede aprende o que está nos dados, inclusive o erro: se os exemplos têm viés ou lacuna, a rede reproduz o viés e falha na lacuna, com a mesma confiança com que acerta o resto.
Livros para estudar deep learning
Em ordem, da prática ao fundamento:
- Deep Learning with Python: François Chollet e Matthew Watson, 3ª edição, Manning, 2025. Escrito pelo criador do Keras, cobre Keras 3, TensorFlow, PyTorch e JAX. É o melhor ponto de partida para quem já programa.
- Dive into Deep Learning: Aston Zhang, Zachary Lipton, Mu Li e Alexander Smola, Cambridge University Press, 2023. Cada capítulo tem código que roda, e a versão completa está gratuita no site oficial.
- Deep Learning: Ian Goodfellow, Yoshua Bengio e Aaron Courville, MIT Press, 2016. A referência teórica da área, também gratuita no site oficial. Exige base de matemática.
- Build a Large Language Model (From Scratch): Sebastian Raschka, Manning, 2024. Constrói um modelo no estilo GPT do zero, em PyTorch. É a ponte direta entre deep learning e LLMs.
O que ninguém sabe ainda
- Por que as redes funcionam tão bem: a teoria ainda não explica por completo por que redes com mais parâmetros do que exemplos conseguem generalizar.
- O que cada camada guarda: a interpretabilidade, área que tenta ler o que acontece dentro da rede, avançou, mas ainda não explica as decisões de um modelo grande de ponta a ponta.
- Como cada modelo pesa no ranking: o Google lista o BERT e os outros sistemas, mas não publica quanto cada um influencia o resultado final.
Checklist para começar
- Veja se precisa de deep learning: para dados em tabela e poucos exemplos, comece por um modelo clássico.
- Prefira modelos prontos: para texto e imagem, um modelo já treinado resolve a maior parte dos casos de SEO e marketing.
- Separe dados de teste: meça o acerto sempre em exemplos que ficaram fora do treino.
- Escolha uma biblioteca: Keras para começar, PyTorch quando for mais fundo.
- Escreva para o significado: no SEO e no GEO, trechos claros e específicos funcionam melhor com modelos que comparam significados.
- Automatize com cuidado: ao usar modelos pelo n8n, revise uma amostra das respostas antes de confiar no fluxo inteiro.
Perguntas frequentes sobre deep learning
Perguntas frequentes sobre deep learning
O que é deep learning, em poucas palavras?
É a parte do machine learning que usa redes neurais com muitas camadas. Cada camada aprende a representar o dado de um jeito mais abstrato que a anterior, e a rede descobre sozinha quais características importam.
Qual a diferença entre machine learning e deep learning?
Deep learning está dentro do machine learning. No machine learning clássico, uma pessoa escolhe as características que o modelo usa. No deep learning, a rede aprende essas características a partir do dado bruto, mas precisa de mais dados e mais computação.
ChatGPT é deep learning?
Sim. O ChatGPT é uma LLM, e toda LLM é um modelo de deep learning construído sobre a arquitetura Transformer, apresentada em 2017.
O Google usa deep learning na busca?
Sim. O BERT, colocado na busca em 2019, e o MUM são modelos de deep learning listados no guia de sistemas de ranqueamento do Google. Saiba mais em machine learning, linguagem Python e IA.
Preciso de placa de vídeo para estudar deep learning?
Para os primeiros exemplos, não. Redes pequenas, como a do exemplo deste artigo, treinam em segundos em um computador comum. A placa de vídeo passa a fazer diferença com redes maiores e muitos dados.
Onde isso se conecta
Deep learning é a camada que sustenta a busca com IA. A base está em Machine learning: significado, linguagem Python e IA. A previsão da próxima palavra está em LLMs: como a IA escolhe quais conteúdos mostrar. E a forma de colocar esses modelos para trabalhar em um processo está em O que é n8n: templates e automação.
Fontes
- Deep learning, LeCun, Bengio e Hinton, Nature
- Fathers of the Deep Learning Revolution Receive ACM A.M. Turing Award, ACM
- Nobel Prize in Physics Awarded for Breakthroughs in Machine Learning, Scientific American
- ImageNet Classification with Deep Convolutional Neural Networks, Krizhevsky, Sutskever e Hinton, NeurIPS
- ILSVRC 2012 Results, ImageNet
- Attention Is All You Need, Vaswani et al., arXiv
- Understanding searches better than ever before, Google
- A guide to Google Search ranking systems, Google Search Central
- load_digits, scikit-learn
- Integrations, n8n
- Dive into Deep Learning, Zhang, Lipton, Li e Smola
- Deep Learning, Goodfellow, Bengio e Courville
Gabriely Rodrigues
Fundadora da Crawlina Tech, especialista em SEO técnico, embaixadora e professora na EducaSEO. Investiga como a busca com IA encontra, entende e cita conteúdo.