Você já perguntou alguma coisa pro ChatGPT ou pro Gemini e recebeu uma resposta com fonte citada, quase como se ele tivesse “pesquisado” antes de responder? Pois é exatamente isso que aconteceu. E entender esse mecanismo pode ser a diferença entre o seu conteúdo ser citado numa resposta de IA ou simplesmente não existir para ela.
Antes de mais nada, o que é RAG?
Se você chegou até aqui, provavelmente já ouviu falar em LLM, em busca com IA, ou já percebeu que o Google mudou. Muito bem, você está no lugar certo. Mas antes de falar de estratégia, precisamos entender o mecanismo por trás dela, porque é ele que explica tudo o que vem depois.
RAG é a sigla para Retrieval-Augmented Generation, ou geração aumentada por recuperação, em português. Na prática, é o processo que permite a um modelo de linguagem buscar informação externa no momento em que responde, em vez de confiar só no que aprendeu durante o treinamento.
Pensa assim: um modelo de linguagem sem RAG é como alguém respondendo uma prova só com o que decorou. Ele pode saber muita coisa, mas o conhecimento dele parou numa data específica, e ele não tem como confirmar se aquilo ainda é verdade. Um modelo com RAG é como alguém que, antes de responder, dá uma consultada rápida em fontes atualizadas e monta a resposta com base no que encontrou. É mais lento, mas é mais confiável, e principalmente, é verificável.
De onde veio esse conceito
O termo não é marketing recente disfarçado de novidade. RAG foi apresentado formalmente em 2020, num artigo de pesquisadores do FAIR, o laboratório de inteligência artificial da Meta, liderado por Patrick Lewis. A motivação original era resolver um problema bem específico: modelos de linguagem “alucinam”, ou seja, inventam informação com total confiança, porque eles geram texto prevendo a próxima palavra mais provável, não consultando fato algum.
RAG nasceu como uma resposta técnica a esse problema, não como estratégia de marketing. Isso importa saber, porque explica por que o mecanismo prioriza precisão e verificabilidade acima de tudo, e é exatamente por isso que conteúdo vago, promocional ou sem fonte tem dificuldade de ser recuperado por ele.
Como o RAG funciona, sem complicar
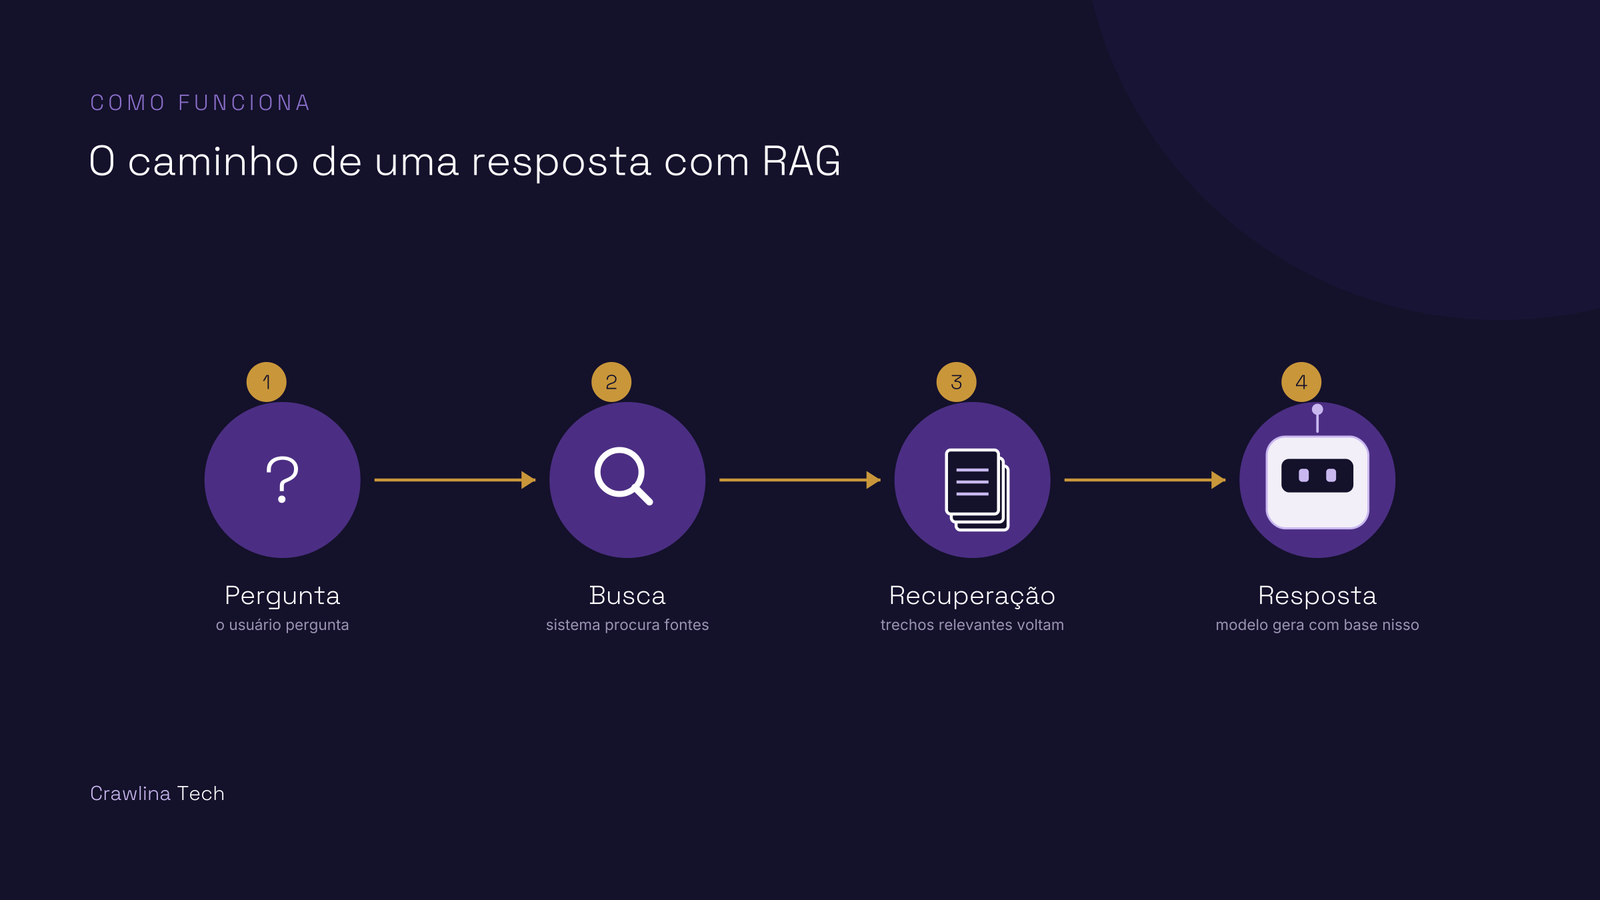
O processo acontece em algumas etapas, e cada uma delas importa pra quem quer ser encontrado por esse mecanismo:
- Fatiamento do conteúdo. Antes de qualquer busca acontecer, o conteúdo da internet precisa ser dividido em pedaços menores, chamados de chunks. Uma página inteira raramente é usada de uma vez, ela é quebrada em trechos que fazem sentido sozinhos.
- Indexação vetorial. Cada pedaço vira uma representação matemática do significado dele, não das palavras exatas. É por isso que um modelo consegue conectar “como reduzir o custo de aquisição de cliente” com um texto seu que fala em “diminuir o CAC”, mesmo sem repetir os termos.
- Recuperação. Quando alguém faz uma pergunta, o sistema busca, entre milhões de pedaços indexados, os que têm mais relação de significado com aquela pergunta específica.
- Geração da resposta. Só depois de recuperar esses trechos é que o modelo de linguagem escreve a resposta, usando o que encontrou como base, e não apenas o que já sabia de antemão.
Repara numa coisa importante: em nenhuma dessas etapas o modelo está “escolhendo” o seu site porque gosta dele, ou porque ele é grande, ou porque é conhecido. Ele está escolhendo o pedaço de texto que responde melhor àquela pergunta específica, com mais clareza. É um jogo diferente do SEO tradicional, e por isso a estratégia também precisa ser diferente.
RAG não é a mesma coisa que busca por palavra-chave
Vale um parênteses aqui, porque essa confusão é comum. Busca tradicional, a que você já conhece do Google, funciona majoritariamente por correspondência de termo: se a palavra que você digitou aparece na página, ou em variação próxima dela, existe chance de match.
Busca vetorial, que é a que sustenta o RAG, funciona por proximidade de significado. Duas frases sem nenhuma palavra em comum podem ser consideradas equivalentes pelo sistema, se o significado por trás delas for o mesmo. E o inverso também é verdade: duas frases com palavras idênticas podem ser tratadas como distantes, se o contexto ao redor mudar o sentido.
Isso tem uma consequência prática direta. Otimizar um texto repetindo a palavra-chave “SEO técnico” quinze vezes, prática que já era ultrapassada no Google tradicional, é ainda menos eficaz aqui. O que pesa é a clareza conceitual do trecho, não a frequência de um termo específico dentro dele.
Por que isso muda o jeito de estruturar conteúdo
Agora que você entende o mecanismo, dá pra entender por que ele muda tudo:
1. Cada parágrafo precisa fazer sentido sozinho. Se o conteúdo depende do parágrafo anterior pra ser entendido, e ele for cortado num chunk separado, a resposta que o modelo constrói fica incompleta ou errada. Clareza por trecho importa mais do que fluidez de texto corrido.
2. Estrutura marcada favorece a recuperação. Título, subtítulo, lista, pergunta e resposta direta. Tudo isso ajuda o sistema a identificar onde começa e termina uma ideia completa, o que aumenta a chance daquele trecho ser recuperado como resposta.
3. Dado estruturado vira sinal de confiança. Schema markup não é só para rich snippet no Google tradicional. Ele ajuda sistemas de IA a confirmar do que se trata aquele conteúdo, sem precisar inferir a partir do texto solto.
4. Ser citado não depende de ranquear em primeiro. Como o mecanismo busca por significado, não por posição em lista de resultado, uma página bem estruturada pode ser recuperada mesmo sem estar na primeira posição do Google tradicional. E o contrário também é verdade: estar em primeiro não garante nada aqui.
Na prática: o que muda ao escrever um parágrafo
Traduzindo os quatro pontos acima em decisão de escrita, no dia a dia:
- Evite parágrafos que começam com “isso” ou “essa estratégia” sem repetir do que está falando. Se aquele trecho for lido sozinho, fora de contexto, “isso” não quer dizer nada.
- Responda a pergunta no primeiro ou segundo período do parágrafo, não no final dele. Sistemas de recuperação priorizam trechos que entregam a resposta rápido.
- Use número, dado e definição direta em vez de rodeio. “RAG reduz alucinação porque ancora a resposta em fonte recuperada” recupera melhor do que um parágrafo de contexto antes de chegar nessa frase.
Se fosse só isso, todo mundo já estaria sendo citado
Calma, porque aqui mora o ponto que a maioria do conteúdo sobre GEO por aí não conta. Estruturar bem um texto ajuda, mas não é garantia de citação, e desconfie de quem promete isso.
O sistema de recuperação compete entre milhões de pedaços de conteúdo parecidos. Se a sua explicação sobre um tema é tecnicamente idêntica a outras cem que já existem na internet, não tem estrutura de texto que resolva, porque o problema não é de formato, é de originalidade. É a mesma lógica de sempre, só que mais exposta: conteúdo raso perde pra conteúdo específico, e agora isso é medido pelo próprio mecanismo de busca, não só pelo leitor.
Tem outro erro comum, que é tratar RAG como se fosse só sobre o Google. Não é. O mesmo mecanismo está por trás de praticamente todo assistente de IA que busca informação externa antes de responder, o que significa que essa não é uma otimização pontual pra uma plataforma, é uma mudança estrutural em como conteúdo é encontrado, ponto.
O que vem depois de entender RAG
Entender como a informação é buscada e recuperada é só a primeira camada. A próxima pergunta é o que acontece depois que esse conteúdo chega até o modelo: como ele processa, pondera e decide o que efetivamente vira resposta. Isso é assunto pra falar sobre LLMs, que é o próximo artigo dessa série.
E só depois de entender as duas camadas é que faz sentido falar de estratégia de verdade, que é o que tratamos em GEO e Busca com IA.
Se você trabalha com um site que depende de tráfego orgânico pra gerar receita, essa não é uma leitura opcional pra daqui a alguns meses. Isso já está acontecendo agora. Se quiser conversar sobre como isso se aplica ao seu caso específico, me chama.
Deixe um comentário