Pergunta pra um LLM o que ele acha de alguma decisão difícil, e ele pondera os dois lados, evita afirmar demais, às vezes até soa cauteloso de um jeito quase humano. Isso não é opinião, no sentido que você imagina. Mas também não é acidente. É treino, e entender esse treino muda o que você deveria esperar desse tipo de resposta.
Antes de mais nada, isso não vem da previsão de próxima palavra
No artigo sobre LLMs, ficou claro que o mecanismo central é previsão estatística: o modelo calcula qual é a próxima palavra mais provável, dado tudo que veio antes. Esse mecanismo sozinho explica fluência, coerência, capacidade de generalizar pra situação nova. Mas ele não explica por que um modelo pondera, evita afirmação categórica, ou parece ter cautela em assunto sensível. Isso vem de uma etapa diferente, aplicada depois do treino principal.
De onde veio esse conceito
A técnica se chama aprendizado por reforço com feedback humano, RLHF na sigla em inglês, e foi formalizada num artigo de 2022 da OpenAI, “Training language models to follow instructions with human feedback”, de Long Ouyang e outros pesquisadores. Foi esse trabalho que deu origem ao InstructGPT, e o método se tornou padrão em praticamente todo modelo de linguagem voltado pra conversa que existe hoje.
O motivo do RLHF existir é simples de entender: um modelo treinado só pra prever a próxima palavra, sem nenhum ajuste depois, tende a produzir texto inconsistente, às vezes tóxico, às vezes simplesmente inútil, porque ele está reproduzindo o que existe na internet, sem filtro de qualidade nenhum.
Como o treino de preferência funciona, sem complicar
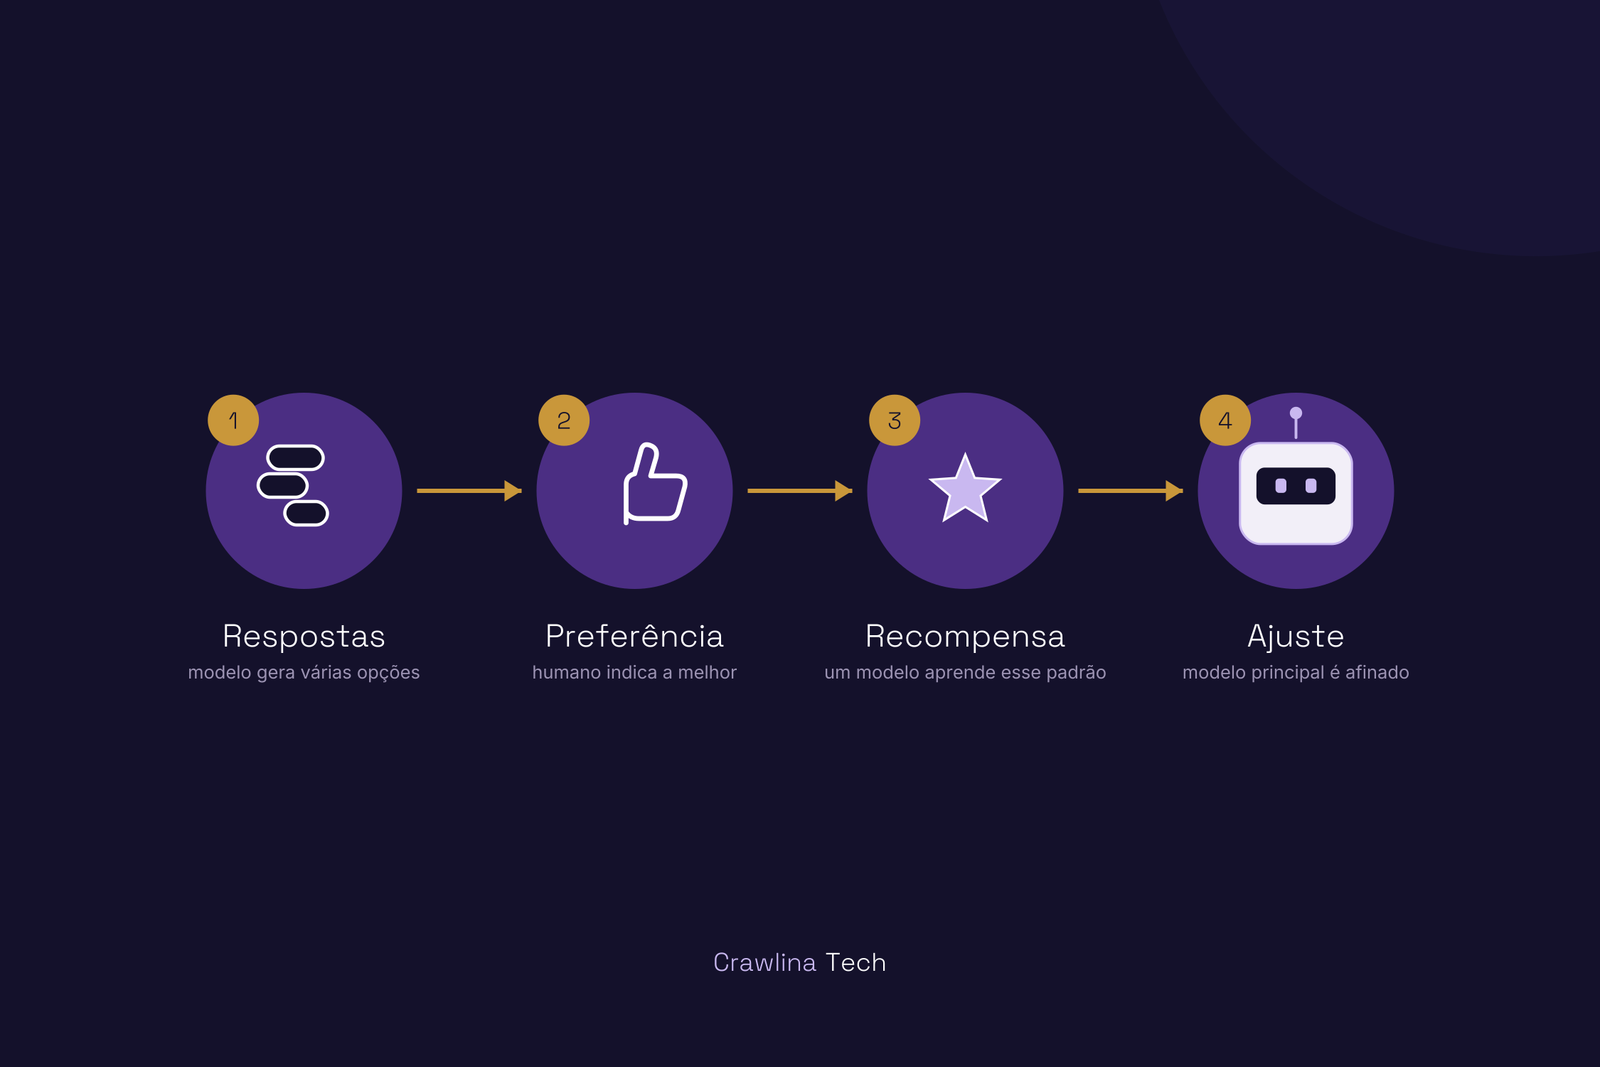
O processo acontece em etapas, depois que o modelo já sabe prever texto:
- Geração de respostas múltiplas. Pra uma mesma pergunta, o modelo gera várias respostas diferentes.
- Avaliação humana. Uma pessoa compara essas respostas e indica qual prefere, considerando clareza, utilidade, segurança, equilíbrio.
- Treino de um modelo de recompensa. Essas preferências alimentam um segundo modelo, cuja única função é prever qual resposta um humano prefere, sem precisar de um humano real avaliando cada vez.
- Ajuste fino do modelo original. O modelo de linguagem principal é então ajustado pra gerar respostas que o modelo de recompensa pontua bem, reforçando o padrão que humanos preferiram.
O resultado dessas quatro etapas é um modelo que não ficou mais inteligente, ficou mais alinhado com o que humano avaliador considerou uma resposta boa. Ponderação em assunto delicado, recusa em pedido perigoso, tom equilibrado em tema polêmico, tudo isso é padrão aprendido, reforçado porque avaliadores humanos pontuaram esse tipo de resposta mais alto do que a alternativa.
Por que isso importa pra quem escreve conteúdo
1. Conteúdo que imita o padrão preferido tende a soar mais “confiável” pro modelo. Texto equilibrado, que reconhece limite e contexto em vez de afirmar de forma absoluta, se parece mais com o que o treino de preferência reforçou. Isso não é garantia de citação, mas reduz o atrito.
2. Afirmação categórica sem ressalva soa como sinal de baixa qualidade. Alegação absoluta, sem nuance nenhuma, é exatamente o tipo de resposta que avaliador humano tende a pontuar mais baixo no treino de RLHF. Conteúdo escrito nesse mesmo estilo herda essa desconfiança por associação de padrão.
3. Conteúdo manipulativo é reconhecido como padrão, não só como conteúdo. Linguagem de urgência forçada, promessa exagerada, gatilho emocional artificial, são exatamente o tipo de texto que avaliador humano historicamente rejeitou durante o treino. O modelo aprendeu a reconhecer esse padrão de escrita como baixa qualidade, independente do assunto.
Se fosse só sobre parecer educado, seria fácil enganar
Calma, porque a leitura errada aqui é achar que basta escrever de forma equilibrada e cordial que o modelo passa a “confiar” no conteúdo. Não é assim. O treino de preferência afeta como a resposta final é formulada, o tom, a ponderação, a cautela. Ele não substitui a etapa de recuperação, explicada no artigo de RAG, nem a competição entre fonte, explicada no artigo sobre como a IA escolhe qual fonte citar.
Em outras palavras: tom equilibrado ajuda o modelo a formular uma resposta mais confiável a partir do que foi recuperado. Ele não faz o conteúdo ser recuperado em primeiro lugar. São camadas diferentes, e confundir uma com a outra é o erro mais comum de quem começa a escrever pensando em IA.
E um ponto final, importante de verdade: nada disso significa que o modelo “acredita” em alguma coisa. Ele aprendeu qual formulação humanos tendem a preferir, e reproduz esse padrão com muita consistência. É indistinguível de opinião na superfície. Por baixo, continua sendo padrão aprendido, não convicção.
Perguntas frequentes sobre Opinião das IAs
A Inteligência Artificial Generativa tem valores próprios?
Não, no sentido de convicção genuína. O que existe é um padrão de resposta reforçado porque avaliadores humanos, durante o treino, pontuaram esse tipo de formulação mais alto do que alternativas. É comportamento aprendido e reproduzido com consistência, não crença.
Diferentes IAs, tipo ChatGPT, Claude e Gemini, têm “personalidades” diferentes porque podem opinar?
Sim, é razoável explicar boa parte da diferença de tom entre elas assim. Cada empresa treina com equipe de avaliação própria, critério próprio do que conta como resposta boa, então o padrão reforçado varia de um modelo pro outro, mesmo quando o mecanismo de base, a previsão de próxima palavra, é conceitualmente parecido.
Dá pra “manipular” o trenamento das IAs escrevendo de um jeito específico?
Escrever com tom equilibrado ajuda o modelo a formular a resposta final de forma mais confiável, mas isso não substitui a etapa de recuperação de fonte nem a competição entre candidatos, explicadas nos outros artigos desta série. Tom sozinho não faz um conteúdo fraco ser recuperado em primeiro lugar.
Treinar IAs generativas pode ser uma forma de censura?
São mecanismos diferentes, vale separar. Censura, no sentido tradicional do termo, é uma autoridade externa impedindo que um conteúdo já existente circule. Alinhamento é um processo de treino que molda quais padrões de resposta um modelo privado tende a gerar, antes mesmo de qualquer resposta existir. Cada empresa define seus próprios critérios de treino, e esse é justamente um dos temas mais debatidos publicamente sobre IA hoje, sem consenso fechado.
Onde isso se conecta
Este artigo parte do que já foi explicado em LLMs, sobre como o modelo processa e prevê texto. Junto com RAG e com o artigo sobre como a IA escolhe qual fonte citar, essas quatro peças formam a base técnica completa antes de qualquer estratégia, que é o assunto de GEO e Busca com IA.
Se quiser entender como isso se aplica ao tom e à estrutura do conteúdo do seu site, me chama.