Bolha de IA: qual impacto nas LLMs e no SEO Técnico
Neste artigo
Se o dinheiro que sustenta a frota de crawlers e a recuperação de respostas em tempo real da IA encurtar, o primeiro lugar em que isso aparece não é em um relatório de marketing. É o seu log de servidor.
Em outubro de 2026, o FMI colocou uma possível correção no mercado de inteligência artificial entre os três principais riscos para a estabilidade financeira global. No mesmo mês, as ações da CoreWeave, da Nebius e da IREN, empresas de infraestrutura de IA, acumulavam quedas de pelo menos 30%, segundo a CNBC.
Se você trabalha com SEO e GEO, a pergunta aparece sozinha: se a bolha estourar, o que acontece com a busca por IA, com as LLMs e, principalmente, com consultores e agências de GEO? Aqui eu respondo pelo lado técnico: por onde o dinheiro chega ao seu servidor, o que dá para medir hoje e quais hipóteses vale monitorar.
Este texto trata de SEO técnico. Não é recomendação de investimento.
O que o FMI disse e o que não disse
O Relatório de Estabilidade Financeira Global de outubro de 2026, publicado em 13 de outubro, aponta três riscos de curto prazo. Um deles é uma correção nos preços de ativos ligados à IA, caso o investimento e a lucratividade em IA se mostrem menos duráveis do que o esperado. Os outros dois são a alta nos juros dos títulos soberanos e as ameaças cibernéticas.
O alerta é condicional. A correção seria amplificada pela alavancagem crescente e pela concentração de exposições. Ele fala de preço de ativo e de financiamento. Não diz que a tecnologia deixa de funcionar.
Os números que alimentam o debate
- Investimento: o gasto das cinco maiores operadoras de nuvem, Alphabet, Amazon, Meta, Microsoft e Oracle, deve passar de US$ 690 bilhões em 2026, alta de mais de 80% em um ano, segundo a FactSet citada pela Exame.
- Financiamento entre as próprias empresas: em agosto de 2026, a Nvidia anunciou apoio financeiro de até US$ 105 bilhões ao data center da OpenAI em Ohio.
- Sinais de estresse: as ações de empresas de infraestrutura que receberam apoio da Nvidia caíram pelo menos 30% em outubro, segundo a CNBC.
Até onde as fontes consultadas mostram, não houve colapso generalizado do setor. Há risco medido, não desfecho confirmado.
Minha definição
Para mim, bolha de IA é o descompasso entre o preço pago pelos ativos e a receita que a tecnologia consegue gerar para justificá-lo. É uma discussão sobre valuation, dívida e retorno. Não é uma discussão sobre se as pessoas vão continuar usando a IA como canal de busca. Para o SEO técnico, a pergunta útil é outra: que parte da cadeia de crawl, recuperação e indexação depende desse dinheiro, como eu enxergo isso no meu servidor.
Três camadas em que a bolha de IA encosta no SEO técnico
1. Crawl: treino, busca e usuário são coisas diferentes
Cada operador de IA roda mais de um robô, com finalidades distintas. Pela divisão do Cloudflare Radar em agosto de 2026, reproduzida em um guia de GEO, no tráfego de crawl da OpenAI o GPTBot (treino) respondia por 78,9%, o ChatGPT-User (ação do usuário) por 14,5% e o OAI-SearchBot (busca) por 6,7%. Na Anthropic, o ClaudeBot (treino) tinha 75,1%, o Claude-SearchBot (busca) 24,1% e o Claude-User 0,9%.
Essa separação importa porque a documentação da Anthropic é explícita: bloquear o ClaudeBot não bloqueia o Claude-User nem o Claude-SearchBot, que usam tokens próprios no robots.txt. Desativar o Claude-SearchBot, segundo a empresa, pode reduzir a visibilidade nos resultados de busca. Se o orçamento de treino for a parte discricionária da conta, é o volume de treino que tende a se mover primeiro. Isso é hipótese e dá para acompanhar nos logs.
2. Recuperação: custo por consulta e poucos trechos por resposta
Os recursos de IA do Google podem usar a técnica de query fan-out, que dispara várias buscas relacionadas por subtópico para montar uma resposta. Cada resposta custa mais recuperação do que uma busca tradicional. Sob pressão de custo, o que se pode esperar são menos subconsultas e menos trechos por resposta. Também é hipótese, mas tem consequência técnica direta: com menos vagas por resposta, a disputa passa a ser por trechos que se sustentam sozinhos, com hierarquia de títulos coerente, pouca poluição de template e a resposta no início do bloco.
3. Índice: a página precisa estar indexada e elegível
A documentação do Google Search Central sobre recursos de IA diz que não há requisitos adicionais nem otimizações especiais para aparecer nas Visões gerais e no Modo IA. A página precisa estar indexada e elegível a exibir snippet. Isso coloca os controles de snippet, como nosnippet, max-snippet e data-nosnippet, no mesmo patamar do noindex: eles afetam o que pode ser usado nas respostas de IA.
Leia também: Por que o Google vê o seu site em JavaScript e as IAs não
A razão rastreamento/visita muda rápido
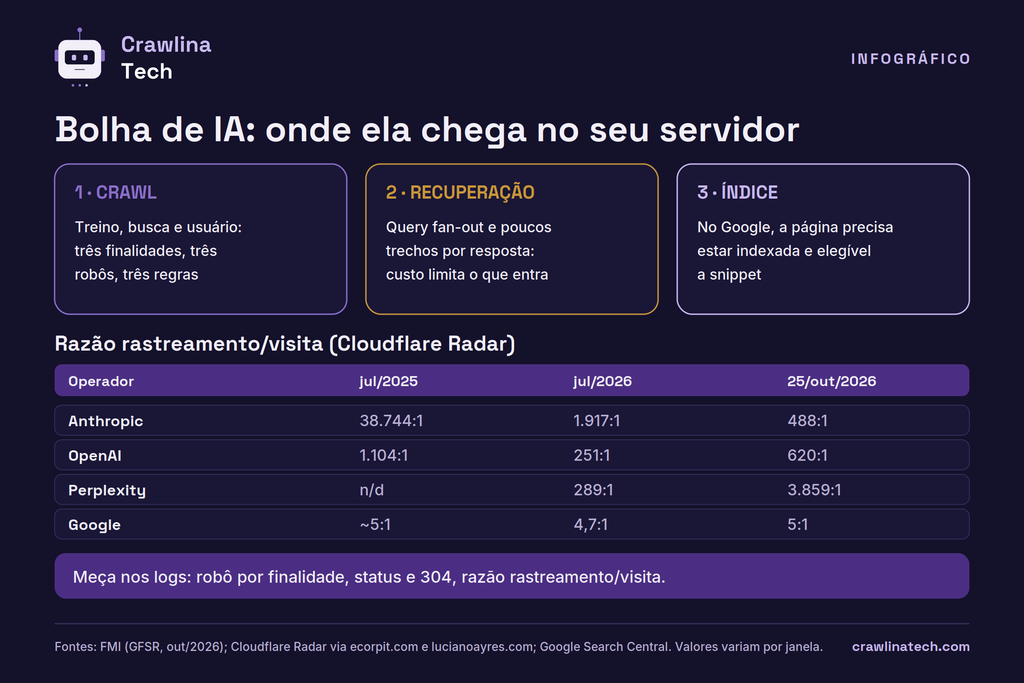
A razão rastreamento/visita (crawl-to-refer) conta quantas requisições HTML um operador faz para cada visita que ele envia de volta. O Cloudflare Radar publica esse número por operador e ele variou bastante em um ano:
| Operador | jul/2025 | jul/2026 | 25/out/2026 |
|---|---|---|---|
| Anthropic | 38.744:1 | 1.917:1 | 488:1 |
| OpenAI | 1.104:1 | 251:1 | 620:1 |
| Perplexity | n/d | 289:1 | 3.859:1 |
| ~5:1 | 4,7:1 | 5:1 |
Os valores acima vêm de relatórios que reproduzem o Cloudflare Radar, e as janelas e a normalização mudam entre eles. Use como ordem de grandeza e confira no painel AI Insights do Radar. O que interessa é a dinâmica: a razão da Anthropic caiu de dezenas de milhares para centenas em um ano, enquanto a da Perplexity subiu em outubro. Não é uma constante. Muda quando muda o mix entre robôs de treino e de busca. É exatamente esse mix que uma correção de mercado tende a mexer.
Hipóteses para monitorar, com o que medir em cada uma
| Hipótese | O que medir |
|---|---|
| Cai o volume de crawl de treino, mas o de busca e usuário se mantém | Participação de cada robô por finalidade nos logs, semana a semana |
| Mais dependência de índices e caches já existentes | Tempo entre publicar e a primeira visita de Googlebot, bingbot e robôs de busca de IA; taxa de 304; acerto do lastmod |
| Menos trechos por resposta, mais disputa por passagem | Citações por consulta nos testes mensais; qualidade da extração do trecho (títulos, boilerplate, resposta no início) |
| Mais bloqueio e cobrança de acesso por parte de provedores de CDN e WAF | Respostas 403 e 429 por robô; falsos positivos do WAF contra robôs legítimos |
Protocolo de medição nos logs
Para separar os robôs por finalidade e ver os status em formato combinado de log:
# contagem por robô
awk -F'"' '{print $6}' access.log | grep -oE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot|bingbot" | sort | uniq -c | sort -rn

# distribuição de status de um robô
grep "ClaudeBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rn- Classifique por finalidade: treino, busca e ação do usuário. Não por empresa.
- Valide a autenticidade: user-agent é falsificável. O Google publica faixas de IP e aceita DNS reverso. A OpenAI publica listas de IP por robô. A Anthropic dizia em versões antigas da documentação que não publicava faixas e uma versão atualizada em abril de 2026, citada por terceiros, aponta uma lista em claude.com/crawling/bots.json. Confirme na página oficial.
- Olhe status e cache: 200, 304, 403, 429 e 5xx por robô. Conditional GET com ETag e Last-Modified reduz o custo de quem rastreia e o seu.
- Calcule a sua razão: requisições HTML por operador divididas pelas visitas com referrer de domínios como chatgpt.com, claude.ai e perplexity.ai. Tire um baseline de quatro semanas.
- Cruze com a indexação: compare o que os robôs de busca de IA pedem com o que o Googlebot e o bingbot já indexaram.
O que ninguém sabe ainda
Para ser honesta, há pontos que não dá para afirmar:
- Se a correção vai acontecer: o FMI descreve um risco, não uma previsão.
- Como ela afetaria o crawl e a recuperação: as hipóteses acima são plausíveis, mas não há dado público que as confirme. A razão rastreamento/visita é uma proxy: mede requisições HTML contra visitas com referrer e não captura respostas entregues sem clique.
- Qual seria o efeito sobre consultores e agências de GEO: ferramentas de monitoramento dependem de consultas a LLMs e à web em escala. Se custos de API e limites de uso mudarem, preço e cobertura dessas ferramentas mudam. Por isso a medição própria, com logs e Search Console, não depende de nenhuma delas.
- Quais fontes as IAs vão citar depois: cada plataforma pode mudar o critério sem avisar.
Checklist técnico para aplicar hoje
- Segmente os logs por robô e finalidade (treino, busca, usuário).
- Valide a autenticidade dos robôs pelas listas de IP ou DNS reverso quando o provedor publica.
- Tire um baseline de quatro semanas de requisições, status, 304 e TTFB por robô.
- Calcule a sua razão rastreamento/visita por operador a partir dos referrers.
- Revise o robots.txt por finalidade, com um bloco para cada token e não por empresa.
- Teste o HTML sem JavaScript nas páginas que os robôs de busca pedem.
- Confira noindex, canonical e controles de snippet, porque a elegibilidade depende deles.
- Configure alertas para picos de robô, 429 e 5xx.
Perguntas frequentes sobre a bolha de IA e o SEO técnico
A bolha de IA vai estourar?
Ninguém sabe. O FMI, em outubro de 2026, apontou a possibilidade de uma correção nos preços de ativos ligados à IA como um dos riscos para a estabilidade financeira, mas não a trata como certa.
O que a bolha de IA muda no SEO técnico?
Nada de imediato. As mudanças possíveis aparecem em crawl, recuperação e indexação, e dá para acompanhar nos logs: mix de robôs por finalidade, status, cache e razão rastreamento/visita.
O que é a razão rastreamento/visita?
É o número de requisições HTML que um operador faz para cada visita que envia de volta ao site. O Cloudflare Radar publica o valor por operador, e ele varia bastante entre janelas.
Bloquear o ClaudeBot tira meu site das respostas do Claude?
Não necessariamente. Segundo a documentação da Anthropic, o ClaudeBot é o robô de treino, e o Claude-User e o Claude-SearchBot têm tokens próprios. Desativar estes dois pode reduzir a visibilidade nas respostas.
Como saber se um robô de IA é verdadeiro?
O user-agent pode ser falsificado. Compare o IP com as listas publicadas pelo provedor, quando existem, e use DNS reverso nos casos em que ele é suportado.
O que o Google exige para eu aparecer nas respostas de IA?
Segundo o Google, a página precisa estar indexada e elegível a exibir snippet, sem requisitos adicionais nem otimizações especiais para as Visões gerais e o Modo IA.
Preciso mudar o robots.txt por causa da bolha?
Não por causa dela. Mas vale organizá-lo por finalidade (treino, busca e usuário), porque isso dá controle independente do cenário.
Onde isso se conecta
Este artigo olha para a infraestrutura e para o servidor. Para o teste do que o robô recebe no HTML, veja JavaScript SEO. Para o que decide uma citação depois do crawl, leia Por que a IA cita um site e ignora outro, Por que a IA opina e o que está por trás e Vale a pena criar o arquivo llms.txt?.
Fontes
- Fundo Monetário Internacional. Global Financial Stability Report, October 2026: Resilience, Risk, and Transformation. 13 out. 2026. imf.org.
- Exame. Bolha da IA? Entenda a rede de dívidas e investimentos que move as Big Techs. exame.com.
- Olhar Digital. Nvidia assume risco bilionário para sustentar boom da IA; mercado acende alerta. 25 out. 2026. olhardigital.com.br.
- Revista Global. Nvidia garante megaprojeto de IA nos EUA. 17 ago. 2026. revistaglobal.com.br.
- Google Search Central. Recursos de IA e seu site. developers.google.com.
- Anthropic. Does Anthropic crawl data from the web, and how can site owners block the crawler? Central de Ajuda. support.claude.com.
- ECORPIT. Crawl-to-refer ratios July 2026, com dados do Cloudflare Radar. ecorpit.com.
- Luciano Ayres. AI crawl-to-refer ratio, com dados do Cloudflare Radar em 25 out. 2026. lucianoayres.com.
- Sunil Pratap Singh. AI Crawler Statistics: What Cloudflare Data Shows. sunilpratapsingh.com.
Gabriely Rodrigues
Fundadora da Crawlina Tech, especialista em SEO técnico, embaixadora e professora na EducaSEO. Investiga como a busca com IA encontra, entende e cita conteúdo.