RAG na prática: por que a IA cita um site e ignora outro
Neste artigo
Dois sites falam do mesmo assunto. Os dois estão indexados, os dois aparecem no Google. Você faz a pergunta numa IA com busca ativada e ela cita só um. O outro simplesmente não existe naquela resposta.
Isso não é sorte e também não é só autoridade de domínio. Quase sempre, a diferença está no trecho que cada site oferece para a IA aproveitar.
Eu sou o Gustavo Assis, desenvolvedor fullstack especialista que também atua com SEO, e neste artigo explico como o RAG escolhe suas fontes na visão técnica, o que a pesquisa já mostrou sobre isso e o que você pode ajustar no seu conteúdo.
Onde a escolha acontece: do índice à resposta
RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação) é o jeito da IA buscar fontes antes de escrever a resposta, sem depender apenas da memória do treinamento. A explicação completa do mecanismo, com chunks e indexação vetorial, você ode ler neste artigo: mecanismo por trás da citação em resposta de IA. Aqui eu vou direto ao ponto em que um site é escolhido e outro é descartado.
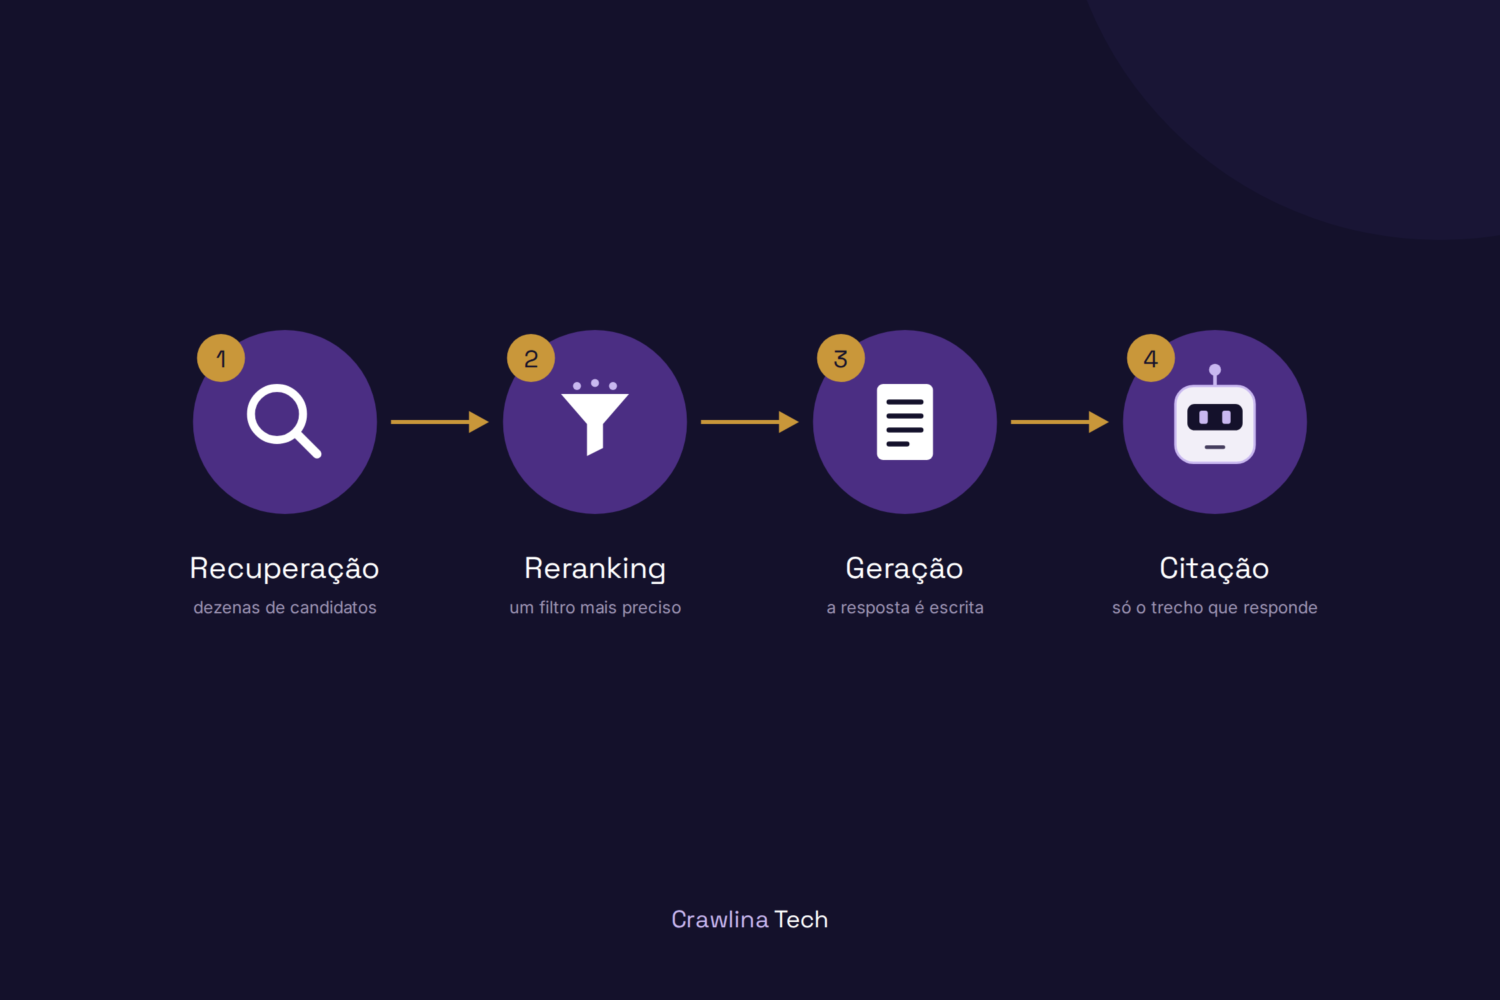
Para o seu conteúdo, o que importa é a ordem dos acontecimentos:
- Recuperação: o sistema busca no índice os trechos mais próximos da pergunta em significado. Costumam entrar dezenas de candidatos.
- Reranking (reordenação): um segundo filtro, mais preciso, avalia a pergunta e cada candidato juntos e descarta quem não responde bem.
- Geração: o modelo escreve a resposta com o que sobrou e cita as fontes.
O detalhe incômodo é que ser recuperado não garante ser citado. Segundo Pedro Dias, ex-integrante do time de Search Quality do Google, uma página que cobre o tema de forma ampla pode passar na primeira etapa e perder na segunda para outra que responde à pergunta de forma direta.
Minha definição
Para mim, RAG na prática é um concurso de trechos, não de sites. A IA não pergunta “qual site é mais forte?”. Ela pergunta “qual pedaço de texto responde melhor a isto, com evidência que eu consiga aproveitar?”.
Isso não quer dizer que autoridade não conta. Ela ajuda o seu trecho a entrar na disputa. Mas, dentro da disputa, quem sai citado é o trecho. Quem escreve pensando só em palavra-chave e backlink chega na porta e não passa dela.
Estar no top 10 do Google não garante nada
Uma análise da Forbes com 4 milhões de URLs de AI Overviews, relatada pela agência Mintec em Your #1 Organic Ranking Does Not Get You Cited in AI Overviews, mostra o tamanho da distância:
“only 38% of cited pages also appeared in the top 10 organic results”
Traduzindo: só 38% das páginas citadas nos AI Overviews apareciam também entre os dez primeiros resultados orgânicos para a mesma busca. Cerca de um terço das citações veio de páginas fora do top 100.
Isso não significa que o SEO tradicional perdeu a utilidade. A Ahrefs lembra que muitos assistentes de IA consultam motores como Google e Bing para montar o grupo inicial de páginas, então estar indexado continua sendo a porta de entrada. O que muda é o critério depois da porta.
Ser selecionado é uma coisa, ser absorvido é outra
O estudo From Citation Selection to Citation Absorption, de Zhang Kai, He Xinyue e Yao Jingang (arXiv, 2026), analisou 602 prompts em ChatGPT, Google AI Overview/Gemini e Perplexity, com 21.143 citações e 18.151 páginas lidas. Os autores separam o processo em duas fases:
- Seleção: a plataforma escolhe a sua URL como fonte.
- Absorção: o texto da sua página realmente entra na resposta, com linguagem, evidência ou estrutura.
Os números mostram que as duas coisas andam separadas. Em média, o Perplexity citou 16,35 fontes por pergunta e o ChatGPT, 6,88. Só que a influência média por página citada foi muito maior no ChatGPT (0,2713) do que no Perplexity (0,0646). Aparecer na lista de fontes é uma coisa. Moldar a resposta é outra.
Segundo os autores, a página precisa primeiro ser elegível, por autoridade e reconhecimento, e depois ser útil, por alinhamento semântico, estrutura legível e densidade de evidências.
Um aviso de honestidade: é um preprint de pesquisadores independentes e a “influência” é uma métrica construída pelos próprios autores, não uma medida direta do que acontece dentro dos modelos. Eles deixam claro que os dados descrevem padrões e não provam causa.
Leia também: Como transformar cinco mecanismos em uma estratégia?
O que as páginas mais aproveitadas têm em comum: evidência
O trabalho mais conhecido do tema é GEO: Generative Engine Optimization, de Pranjal Aggarwal e colegas (Princeton e IIT Delhi, KDD ’24). Eles criaram o GEO-bench, com 10 mil consultas, e testaram nove técnicas de otimização. As que mais funcionaram foram citar fontes, incluir falas de fontes relevantes e adicionar estatísticas, com ganhos de 30% a 40% na métrica de contagem de palavras ajustada pela posição.
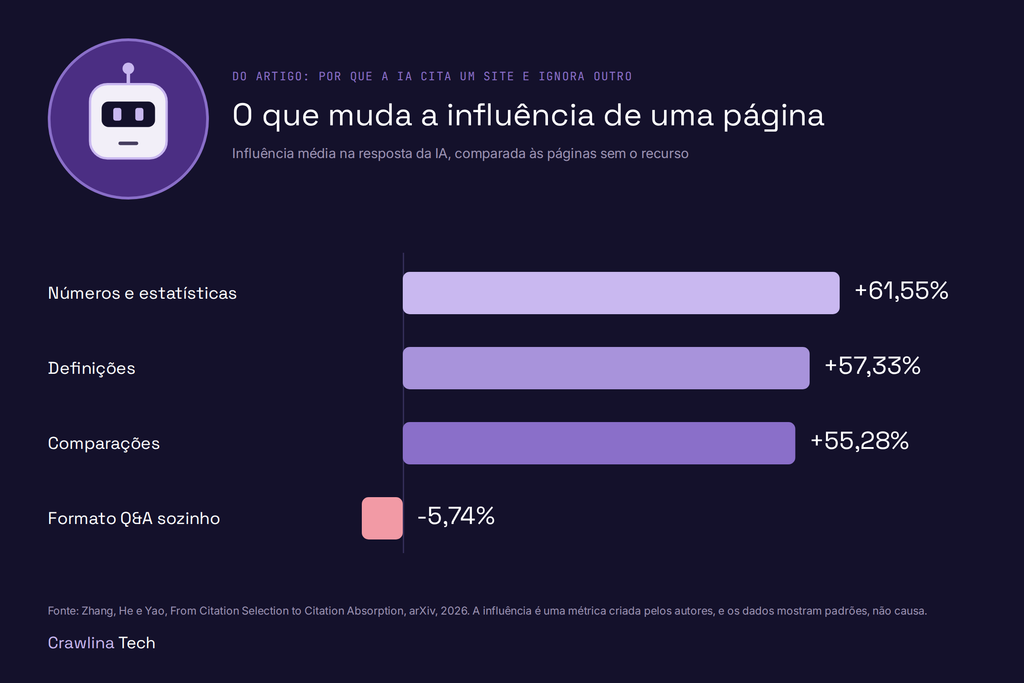
O estudo de Zhang e colegas segue na mesma direção. Páginas com números e estatísticas tiveram influência média 61,55% maior do que as sem eles. Para definições, a diferença foi de 57,33%, e para comparações, de 55,28%. Entre o quarto mais influente e o menos influente, as páginas do topo tinham 11,44 vezes mais palavras e 12,5 vezes mais cabeçalhos.
Calma, isso não é um convite para inflar texto. Os autores explicam que o tamanho só ajuda quando vem junto de estrutura utilizável e evidência. A hipótese deles é a do contêiner de evidências: uma página que reúne várias unidades prontas para reaproveitar (definição, dado, comparação, passo a passo) é mais fácil de aproveitar do que um texto corrido genérico. É uma hipótese coerente com os dados, não uma lei comprovada.
Em vez de escrever “nosso método é muito eficiente”, escreva algo como “reduzimos o tempo de carregamento de 4,2s para 1,8s em 30 dias” (exemplo ilustrativo). O segundo é um trecho que a IA consegue aproveitar e que alguém consegue verificar.
Repetir palavra-chave não ajuda
Aggarwal e colegas também testaram o velho enchimento de palavras-chave. Segundo os autores, técnicas amplamente usadas em SEO como essa trazem “little to no improvement”, ou seja, pouca ou nenhuma melhora nas respostas dos motores generativos. No teste com o Perplexity, o enchimento ficou cerca de 10% abaixo da página sem otimização em uma das duas métricas do estudo (a contagem de palavras ajustada pela posição).
Pensa assim: o motor não está contando quantas vezes você disse a palavra. Está medindo se o trecho responde.
FAQ sozinho não resolve
Muita gente transformou o site inteiro em perguntas e respostas achando que era a fórmula. O estudo de Zhang e colegas não confirma. Na amostra, as páginas em formato Q&A tiveram influência média de 0,0947, contra 0,1005 das demais, uma diferença de -5,74%. Para os autores, “Q&A formatting alone is weak”: o formato pergunta e resposta sozinho é fraco.
Eles também avisam que isso não prova que FAQ atrapalha. Muitas páginas de FAQ são finas, e isso pode explicar parte do resultado.
Aqui as fontes divergem. A Ahrefs, com base em dados de Kevin Indig, aponta que o conteúdo no formato pergunta seguida de resposta imediata foi citado cerca do dobro das vezes (18% contra 8,9%). Pedro Dias também diz que conteúdo organizado em torno de perguntas claras e respostas diretas tende a ir melhor no reranking.
Meu posicionamento: as duas leituras convivem. A pergunta ajuda o trecho a encontrar a busca. A evidência é o que faz a IA aproveitar a resposta. Use perguntas como títulos quando elas refletirem dúvidas reais, e nunca como substituto de conteúdo.
Resposta no começo e conteúdo atualizado
Dois padrões aparecem com força nas fontes:
- A IA olha o topo: em um estudo de Kevin Indig com 1,2 milhão de citações do ChatGPT, reportado pela Ahrefs, os primeiros 30% do texto da página geraram 44,2% das citações. O terço do meio gerou 31,1%, e o final, 24,7%. Daí a recomendação de começar cada seção pela resposta, o chamado Bottom Line Up Front. O mesmo estudo viu mais citações em conteúdo com muitas entidades concretas (nomes, datas, números): cerca de 20,6% das palavras, contra 5% a 8% no conteúdo médio.
- A IA prefere o recente: em uma análise de 17 milhões de citações, a Ahrefs concluiu que as URLs citadas por assistentes de IA são, em média, 25,7% mais recentes que as das páginas orgânicas tradicionais. Uma análise da agência Aether aponta algo parecido para o Perplexity, com cerca de 78% das citações vindas de conteúdo com menos de 12 meses, embora a página não detalhe a metodologia.
Um cuidado prático, também da Ahrefs: a IA muitas vezes lê versões em cache. Se você atualizou ontem, a versão antiga pode continuar circulando por um tempo. Atualize com dados novos e mostre a data, em vez de só trocar a data.
Um trecho forte pode ancorar a resposta
Samuel Yeh e Sharon Li, da Universidade de Wisconsin-Madison, olharam o que acontece dentro do modelo em How Retrieved Context Shapes Internal Representations in RAG (arXiv, 2026). Eles testaram três modelos abertos (Gemma 3, Llama 4 e Qwen3-Next) em perguntas de bases como TriviaQA e Natural Questions. Quando havia ao menos um documento relevante no contexto, o estado interno do modelo ficava próximo do observado com o documento relevante sozinho, e a influência dos documentos irrelevantes diminuía.
Minha leitura, e não uma conclusão dos autores: um único trecho preciso tem mais peso do que dez parágrafos genéricos. O estudo é de laboratório, com modelos abertos, e não mede ChatGPT nem Perplexity. Também não elimina o ruído: a precisão caiu um pouco quando havia documentos que pareciam relevantes mas não ajudavam.
Leia também: Como usar RAG com o ChatGPT?
Acessibilidade técnica também conta
Se a IA não consegue ler a página, ela não cita. Segundo a Ahrefs, os problemas mais comuns são:
- Conteúdo dependente de JavaScript: textos em abas, acordeões ou dentro de imagens costumam ficar inacessíveis para bots de IA, que tendem a trabalhar com HTML estático.
- Bloqueios de rastreadores: regras no robots.txt ou no firewall que barram bots como o OAI-SearchBot. Vale conferir também a CDN, já que a Ahrefs aponta que a Cloudflare bloqueia rastreadores de IA por padrão.
- Servidor lento: uma análise de David McSweeney, citada pela Ahrefs, indica que o ChatGPT parece usar um limite de cerca de 2 segundos para buscar a página. Com tempo até o primeiro byte (TTFB) acima de 1 segundo, o conteúdo pode chegar truncado.
Nos sites que audito, o padrão que mais se repete é a ausência total de otimização no servidor: sem cache, sem compressão, sem ajuste de hospedagem. O resultado é um site que responde devagar, e pelo indício acima isso pode custar a citação.
O erro mais comum do cliente é achar que a solução é trocar de tecnologia, quando quase sempre o ganho vem de otimizar o que já existe.
A parte técnica não substitui o conteúdo, mas sem ela o melhor trecho do mundo fica trancado do lado de fora.
O que ninguém sabe ainda
Para ser honesto com você, as fontes deixam algumas perguntas em aberto:
- Schema.org / JSON-LD: Pedro Dias diz que ainda não está comprovado que o schema influencie diretamente a recuperação ou a citação em RAG, e recomenda usá-lo pelos benefícios no SEO tradicional. A Mintec, por outro lado, relata que todos os 29 artigos citados em um estudo de caso tinham FAQ schema, mas é uma amostra pequena e sem controle. Não há consenso.
- Peso da autoridade: Dias afirma que a maioria dos pipelines de RAG não tem um equivalente embutido de PageRank, mas que autoridade ainda pesa por sinais de confiança. A Ahrefs lembra que a camada de busca por trás dos assistentes é um motor tradicional. Minha leitura: as duas coisas podem ser verdade, em etapas diferentes (a entrada no grupo de candidatos e a escolha final).
- Português: os autores do estudo de Zhang avisam que o recorte de idiomas foi inglês e chinês e que os resultados não devem ser generalizados. Até onde as fontes que usei mostram, não há estudo equivalente em português.
- Caixa-preta: os dados são observacionais. Ninguém de fora enxerga o funcionamento interno de ChatGPT, Perplexity e Gemini, e os próprios estudos reconhecem isso.
Checklist para você aplicar hoje
- Resposta primeiro: coloque a resposta principal nas primeiras frases de cada seção.
- Evidência em cada afirmação: inclua um dado, uma definição, uma comparação ou um exemplo concreto.
- Trechos que se sustentam sozinhos: use títulos (H2/H3) que digam o assunto e mantenha cada seção focada em um conceito.
- Fontes à vista. Cite fontes confiáveis e identifique quem disse o quê.
- Atualização com dado novo: revise as páginas principais pelo menos uma vez por ano e mostre a data da última atualização.
- Acesso técnico: garanta HTML acessível, robots.txt e CDN sem bloqueio para os rastreadores de IA que você quer atrair e TTFB abaixo de 1 segundo.
- FAQ com conteúdo: se usar FAQ, que cada resposta traga evidência e não só texto genérico.
Perguntas frequentes sobre r que a IA cita um site e ignora outro
Ranquear em primeiro no Google garante que a IA vai me citar?
FAQ ajuda a ser citado?
Texto mais longo é mais citado?
Com que frequência devo atualizar o conteúdo?
Onde isso se conecta
Este artigo olha para a escolha da fonte. Para a base técnica, com chunks e indexação vetorial, leia RAG, o mecanismo por trás da citação em resposta de IA. E se você quer ver o RAG funcionando com os seus próprios arquivos, o passo a passo está em Como usar RAG com o ChatGPT.
Fontes
- Aggarwal, P. et al. GEO: Generative Engine Optimization. ACM KDD ’24, 2024. arXiv:2311.09735. DOI 10.1145/3637528.3671900.
- Zhang Kai; He Xinyue; Yao Jingang. From Citation Selection to Citation Absorption: A Measurement Framework for Generative Engine Optimization Across AI Search Platforms. arXiv (preprint), abr. 2026. arXiv:2604.25707.
- Yeh, S.; Li, S. How Retrieved Context Shapes Internal Representations in RAG. arXiv (preprint), 2026. arXiv:2602.20091.
- Linehan, L. (revisão de Ryan Law). Retrieval-Augmented Generation (RAG) Explained: How AI Decides Which Pages to Search & Cite. Ahrefs, 22 jul. 2026. ahrefs.com/blog/retrieval-augmented-generation.
- Indig, K. The Science of How AI Pays Attention. Growth Memo. growth-memo.com (dados citados via Ahrefs).
- Dias, P. How LLMs and RAG Systems Retrieve, Rank, and Cite Content. Visively, atualizado em 22 mai. 2026. visively.com.
- Mintec. Your #1 Organic Ranking Does Not Get You Cited in AI Overviews. Mintec Digital Agency, 20 set. 2026 (relata análise da Forbes Tech Council). mintec.co.
- Aether Agency. How Perplexity Selects Sources: Inside the Citation Engine. Aether Agency, 2026. aether-agency.co.uk.
Gabriely Rodrigues
Fundadora da Crawlina Tech, especialista em SEO técnico e professora na EducaSEO. Investiga como a busca com IA encontra, entende e cita conteúdo.